从零到大模型 · AI 工程师成长系列:系列总纲
从 AI 简史到训练世界一流的 Transformer 大语言模型 —— 一套为软件工程师定制的中文教材(共 11 卷)
一、系列简介
本系列面向已经具备扎实编程能力、希望成为专业 AI 工程师的读者,目标是让你最终能够独立参与乃至主导一个世界一流水准的 Transformer 大语言模型的训练:从数据、分词器、模型结构、GPU 内核与分布式训练,一路做到后训练对齐、推理部署与评测。
全系列共 11 卷,分为四个阶段。每一卷都包含:清晰的学习目标、先修要求、章节内容、动手项目和估计学时。所有内容均以简体中文编写,术语首次出现时附英文原文;所有插图均为原创绘制;只引用真实存在的经典论文与著作。
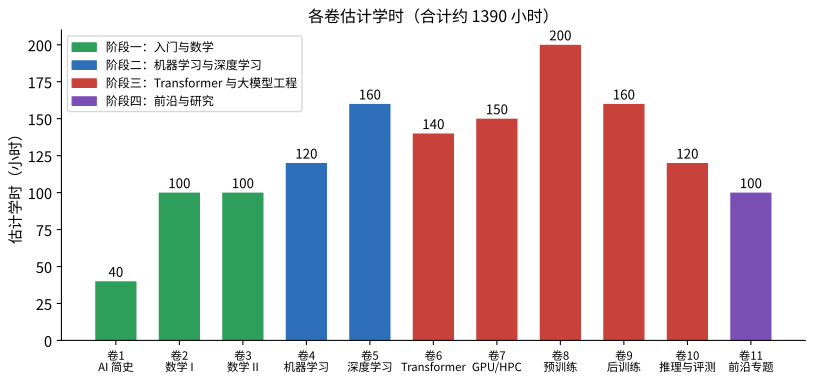
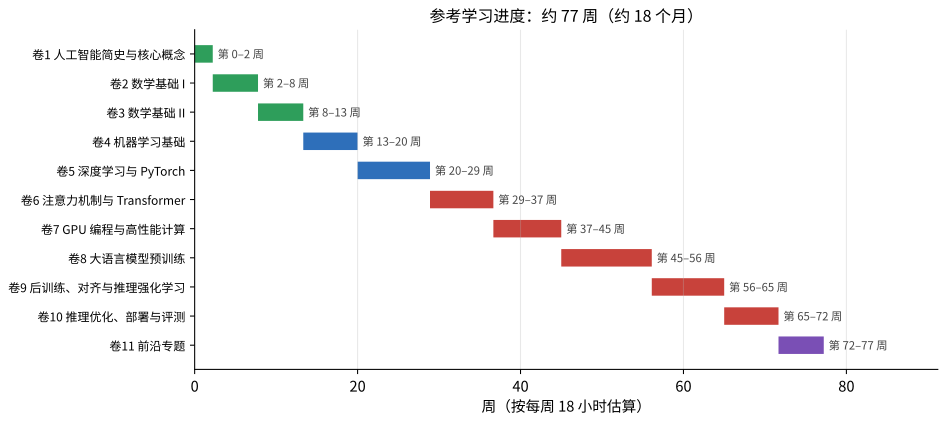
整个系列的总学习时间估计约 1400 小时。按每周 15–20 小时计算,大约需要 18–24 个月。各卷之间有明确的依赖关系(见路线图),但数学基础较好的读者可以快速浏览卷二、卷三,把它们当作参考手册。
二、编写原则
- 从零实现:每个核心算法都先用 NumPy / PyTorch 从零写一遍,再使用成熟的库。
- 原理与工程并重:既推导公式,也测量显存、吞吐和 MFU;既懂“为什么”,也懂“怎么让它在一万块 GPU 上跑起来”。
- 小规模实验,大规模思考:绝大多数现象(规模定律、训练不稳定、过拟合)都可以在单卡小模型上观察到。
- 精读原始论文:每卷列出必读的经典论文,并在正文中逐段精读最关键的几篇。
- 中文语料与场景:项目尽量使用中文数据(古诗词、中文网页、中文数学题),并讨论中文分词与评测的特殊问题。
三、学习路线图
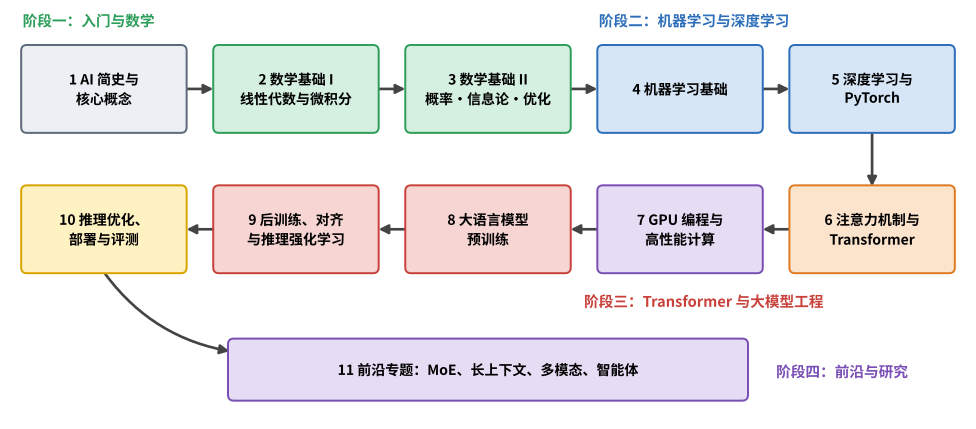
- 阶段一:入门与数学:卷1《人工智能简史与核心概念》、卷2《数学基础 I:线性代数与微积分》、卷3《数学基础 II:概率统计、信息论与优化》
- 阶段二:机器学习与深度学习:卷4《机器学习基础》、卷5《深度学习与 PyTorch》
- 阶段三:Transformer 与大模型工程:卷6《注意力机制与 Transformer》、卷7《GPU 编程与高性能计算》、卷8《大语言模型预训练》、卷9《后训练、对齐与推理强化学习》、卷10《推理优化、部署与评测》
- 阶段四:前沿与研究:卷11《前沿专题:MoE、长上下文、多模态与智能体》
四、全系列一览
| 卷 | 书名 | 阶段 | 先修 | 学时 | 状态 |
|---|---|---|---|---|---|
| 1 | 人工智能简史与核心概念 | 阶段一 | 会使用 Python;无需数学基础。 | 40 | 已完成(本期交付) |
| 2 | 数学基础 I:线性代数与微积分 | 阶段一 | 高中数学;Python 与 NumPy 基础;建议先读卷一。 | 100 | 规划中 |
| 3 | 数学基础 II:概率统计、信息论与优化 | 阶段一 | 卷二(或同等的线性代数与微积分基础)。 | 100 | 规划中 |
| 4 | 机器学习基础 | 阶段二 | 卷二、卷三;熟悉 NumPy。 | 120 | 规划中 |
| 5 | 深度学习与 PyTorch | 阶段二 | 卷二至卷四;Python 熟练。建议具备一块 GPU(本地或云端)。 | 160 | 规划中 |
| 6 | 注意力机制与 Transformer | 阶段三 | 卷五。 | 140 | 规划中 |
| 7 | GPU 编程与高性能计算 | 阶段三 | 卷五、卷六;C/C++ 基础;一块 NVIDIA GPU(本地或云端)。 | 150 | 规划中 |
| 8 | 大语言模型预训练 | 阶段三 | 卷六、卷七。 | 200 | 规划中 |
| 9 | 后训练、对齐与推理强化学习 | 阶段三 | 卷八(至少完成一个基座模型的预训练或使用开源基座模型)。 | 160 | 规划中 |
| 10 | 推理优化、部署与评测 | 阶段三 | 卷六至卷九。 | 120 | 规划中 |
| 11 | 前沿专题:MoE、长上下文、多模态与智能体 | 阶段四 | 卷六至卷十。 | 100 | 规划中 |
五、各卷详细规划
卷1 人工智能简史与核心概念
A Brief History of AI and Core Concepts | 估计学时:40 小时 | 已完成(本期交付)
学习目标
- 理解 AI、机器学习、深度学习与大语言模型的定义与关系
- 掌握 AI 七十余年的关键人物、事件与思想,理解每次繁荣与寒冬的技术原因
- 建立机器学习的核心概念框架:数据、模型、损失、优化、泛化
- 对神经网络、反向传播、Transformer 与规模定律形成准确的全局认识
- 规划个人的 AI 工程师学习路线
先修要求:会使用 Python;无需数学基础。
章节安排
- 什么是人工智能 —— 四种定义视角、图灵测试与中文屋、智能体框架、AI/ML/DL/LLM 的关系、莫拉维克悖论。
- 孕育与诞生:1943—1956 —— 逻辑、可计算性、信息论与控制论;M-P 神经元;图灵 1950;达特茅斯会议与逻辑理论家。
- 黄金年代与第一次寒冬:1956—1980 —— 搜索与启发式、A* 与极小化极大;物理符号系统假设;感知机及其学习规则;XOR 与《感知机》;第一次寒冬。
- 专家系统、联结主义复兴与第二次寒冬:1980—1993 —— 专家系统架构与正向链接;MYCIN、XCON;第二次寒冬;Hopfield 网络、反向传播、万能近似定理与早期 CNN。
- 统计机器学习时代:1993—2011 —— SVM 与核技巧、决策树与集成学习、概率图模型、深蓝、LSTM 与 LeNet-5。
- 深度学习革命:2006—2017 —— 数据、算力、算法三要素;ImageNet 与 AlexNet;ResNet;词向量;Seq2Seq 与注意力;GAN;AlphaGo。
- Transformer 与大模型时代:2017 年至今 —— 自注意力、GPT 与 BERT、规模定律与 Chinchilla、RLHF 与 ChatGPT、DPO、思维链与推理模型、《苦涩的教训》。
- 机器学习核心概念 —— 四种学习范式、工作流程与数据划分、三要素、线性回归与梯度下降、过拟合与偏差—方差、评估指标、没有免费的午餐。
- 神经网络与深度学习概念速览 —— 激活函数、用两层网络解决 XOR、计算图上的反向传播数值例子、表示学习、分词与嵌入、第一个 PyTorch 网络。
- 成为 AI 工程师 —— 能力地图、训练计算量与显存估算、软硬件栈、AI 安全与伦理、系列路线与学习方法。
动手项目
- 手算并编程实现感知机,验证它能学会 AND/OR 但学不会 XOR
- 实现正向链接专家系统并输出推理链
- 用 NumPy 梯度下降实现线性回归,研究学习率对收敛的影响
- 用 PyTorch 训练第一个多层感知机解决 XOR
核心阅读
- Turing (1950). Computing Machinery and Intelligence
- Rumelhart, Hinton & Williams (1986). Learning Representations by Back-propagating Errors
- Vaswani et al. (2017). Attention Is All You Need
- Sutton (2019). The Bitter Lesson
卷2 数学基础 I:线性代数与微积分
Mathematics I: Linear Algebra and Calculus | 估计学时:100 小时 | 规划中
学习目标
- 熟练掌握向量、矩阵、线性变换及其几何直觉
- 理解特征分解、SVD 与低秩近似,并能联系到 PCA 与 LoRA
- 掌握多元微积分与矩阵微积分,能手推线性层、Softmax 的梯度
- 理解前向/反向模式自动微分,并从零实现一个自动微分引擎
- 熟练使用张量、广播与 einsum 推演注意力的形状
先修要求:高中数学;Python 与 NumPy 基础;建议先读卷一。
章节安排
- 向量与向量空间 —— 线性组合、张成、线性无关、基与维数;用 NumPy 操作词向量。
- 矩阵与线性变换 —— 矩阵乘法的四种视角与几何意义;为什么矩阵乘法是神经网络的核心运算。
- 范数、内积与正交 —— L1/L2 范数、余弦相似度、正交投影、Gram-Schmidt;注意力中的点积。
- 线性方程组与矩阵分解 —— 高斯消元、LU 分解、秩与可逆性;最小二乘与正规方程。
- 特征值与特征向量 —— 特征分解、对称矩阵的谱定理、幂迭代;与 RNN 梯度爆炸/消失的联系。
- 奇异值分解与低秩近似 —— SVD、Eckart–Young 定理、PCA;LoRA 低秩适配的数学基础。
- 单变量微积分回顾 —— 极限、导数、泰勒展开;数值微分与浮点误差。
- 多元微积分与梯度 —— 偏导数、梯度、方向导数、雅可比矩阵与黑塞矩阵;损失曲面的几何。
- 矩阵微积分 —— 标量对向量/矩阵求导、常用公式与迹技巧;推导线性层、Softmax + 交叉熵的梯度。
- 链式法则与自动微分 —— 计算图、前向模式与反向模式;从零实现标量与张量自动微分引擎。
- 张量与 einsum —— 高维数组、广播规则、einsum 记号;多头注意力的张量形状推演。
动手项目
- 用 SVD 实现图像压缩并分析奇异值谱
- 从零实现 PCA 并对 MNIST 降维可视化
- 从零实现自动微分引擎(标量版 → 张量版),并通过数值梯度检验
- 用 einsum 一行实现多头注意力的打分计算
核心阅读
- Strang, G. Introduction to Linear Algebra(教材)
- Parr & Howard (2018). The Matrix Calculus You Need for Deep Learning. arXiv:1802.01528
- Baydin et al. (2018). Automatic Differentiation in Machine Learning: a Survey. JMLR
卷3 数学基础 II:概率统计、信息论与优化
Mathematics II: Probability, Information Theory and Optimization | 估计学时:100 小时 | 规划中
学习目标
- 掌握概率论与常见分布,理解期望、方差与协方差
- 理解最大似然估计,并据此推导出各种损失函数
- 掌握熵、交叉熵、KL 散度与困惑度,理解语言模型损失的含义
- 理解梯度下降、动量与 Adam/AdamW 的原理与收敛性
- 理解浮点数格式与混合精度训练的数值基础
先修要求:卷二(或同等的线性代数与微积分基础)。
章节安排
- 概率论基础 —— 样本空间、条件概率、贝叶斯定理与独立性。
- 随机变量与常见分布 —— 伯努利、类别、高斯与多元高斯分布;期望、方差与协方差。
- 极限定理与采样 —— 大数定律、中心极限定理、蒙特卡洛估计;小批量梯度噪声的来源。
- 统计推断 —— 最大似然与最大后验估计、置信区间、假设检验;模型评测中的统计显著性。
- 信息论 —— 熵、交叉熵、KL 散度、互信息;困惑度与“压缩即预测”。
- Softmax、Logits 与采样 —— log-sum-exp 数值稳定技巧、温度、top-k 与 top-p 采样。
- 凸优化基础 —— 凸集与凸函数、最优性条件、拉格朗日对偶;SVM 的对偶形式。
- 梯度下降的理论 —— 收敛速度、条件数与学习率选择;动量与 Nesterov 加速。
- 随机与自适应优化 —— SGD、AdaGrad、RMSProp、Adam、AdamW;学习率预热与衰减;新型优化器的思想。
- 数值计算与浮点数 —— IEEE 754、FP32/FP16/BF16/FP8、上溢与下溢、损失缩放;混合精度的数学基础。
动手项目
- 蒙特卡洛模拟验证中心极限定理
- 计算中文语料的字级熵与 n-gram 困惑度
- 从零实现 SGD/动量/Adam/AdamW,在 Rosenbrock 函数上可视化优化轨迹
- 实验观察 FP16 下溢并实现动态损失缩放
核心阅读
- Cover & Thomas. Elements of Information Theory(教材)
- Boyd & Vandenberghe (2004). Convex Optimization
- Kingma & Ba (2015). Adam: A Method for Stochastic Optimization
- Loshchilov & Hutter (2019). Decoupled Weight Decay Regularization
- Micikevicius et al. (2018). Mixed Precision Training
卷4 机器学习基础
Foundations of Machine Learning | 估计学时:120 小时 | 规划中
学习目标
- 掌握经典监督与无监督学习算法的原理并能从零实现
- 掌握模型评估、交叉验证与实验设计方法,避免数据泄漏
- 理解偏差—方差、正则化与泛化理论
- 能用 scikit-learn 与梯度提升树解决实际的表格与文本问题
先修要求:卷二、卷三;熟悉 NumPy。
章节安排
- 机器学习工程工具链 —— NumPy、pandas、scikit-learn、可视化与实验管理。
- 线性回归与正则化 —— 最小二乘、岭回归、Lasso 及其贝叶斯解释。
- 逻辑回归与 Softmax 回归 —— 交叉熵损失、决策边界、多分类。
- 模型评估与选择 —— 交叉验证、ROC/AUC、校准、学习曲线、数据泄漏。
- k 近邻与核方法 —— 距离度量、维数灾难、SVM 与核技巧。
- 决策树与集成学习 —— CART、随机森林、梯度提升(XGBoost/LightGBM)。
- 无监督学习 —— k-means、高斯混合模型与 EM 算法、PCA、t-SNE/UMAP。
- 概率图模型入门 —— 朴素贝叶斯、隐马尔可夫模型与维特比算法。
- 特征工程与数据处理 —— 缺失值、类别编码、标准化、文本特征 TF-IDF 与中文分词。
- 学习理论初步 —— 偏差—方差分解、VC 维与泛化界、双下降现象。
动手项目
- 从零实现逻辑回归、决策树与 k-means
- 完成一个表格数据竞赛风格项目(梯度提升 + 特征工程)
- TF-IDF + 逻辑回归的中文情感分类基线
- 复现多项式回归中的偏差—方差曲线与双下降现象
核心阅读
- Bishop (2006). Pattern Recognition and Machine Learning
- Hastie, Tibshirani & Friedman (2009). The Elements of Statistical Learning
- 周志华 (2016).《机器学习》
- Chen & Guestrin (2016). XGBoost: A Scalable Tree Boosting System. KDD
卷5 深度学习与 PyTorch
Deep Learning with PyTorch | 估计学时:160 小时 | 规划中
学习目标
- 从零实现神经网络的前向与反向传播
- 熟练使用 PyTorch 构建、训练与调试深度网络
- 掌握初始化、归一化、正则化、优化器与学习率调度等训练技巧
- 理解并实现 CNN、RNN/LSTM、Seq2Seq 与注意力
- 建立系统的深度学习调试与实验方法
先修要求:卷二至卷四;Python 熟练。建议具备一块 GPU(本地或云端)。
章节安排
- 从零实现神经网络 —— 用 NumPy 实现多层感知机的前向与反向传播,在 MNIST 上训练。
- PyTorch 核心 —— 张量、autograd、nn.Module、Dataset/DataLoader、GPU 使用。
- 训练深度网络 —— Xavier/He 初始化、激活函数与损失函数、优化器与学习率调度。
- 正则化与归一化 —— Dropout、权重衰减、数据增强;BatchNorm、LayerNorm、RMSNorm。
- 卷积神经网络 —— 卷积、池化与感受野;实现 LeNet、VGG 与 ResNet。
- 循环神经网络 —— RNN 与随时间反向传播、梯度消失、LSTM 与 GRU;字符级语言模型。
- 序列到序列与注意力 —— 编码器—解码器、Bahdanau 注意力、束搜索。
- 嵌入与表示学习 —— word2vec、自编码器与对比学习。
- 生成模型入门 —— VAE、GAN 与扩散模型的基本思想。
- 调试与实验方法 —— 过拟合单个批次、梯度检查、损失曲线诊断、可复现性与实验追踪。
动手项目
- NumPy 手写 MLP,在 MNIST 上达到 97% 以上准确率
- PyTorch 实现 ResNet 并在 CIFAR-10 上训练
- 字符级 LSTM 生成唐诗
- 带注意力的 Seq2Seq 实现简单的中英翻译
核心阅读
- Goodfellow, Bengio & Courville (2016). Deep Learning
- He et al. (2016). Deep Residual Learning for Image Recognition
- Ioffe & Szegedy (2015). Batch Normalization
- Srivastava et al. (2014). Dropout. JMLR
- Ba, Kiros & Hinton (2016). Layer Normalization
卷6 注意力机制与 Transformer
Attention and the Transformer | 估计学时:140 小时 | 规划中
学习目标
- 彻底理解自注意力、多头注意力、位置编码与 Transformer 块的每一个细节
- 从零实现一个完整的 GPT 风格语言模型并在中文语料上训练
- 掌握现代 LLM 架构改进:RoPE、RMSNorm、SwiGLU、GQA 等
- 理解 FlashAttention 等高效注意力的原理
- 初步掌握 Transformer 的可解释性分析方法
先修要求:卷五。
章节安排
- 注意力的本质 —— 查询、键与值;缩放点积注意力及其几何直觉。
- 自注意力与多头注意力 —— 逐行实现、因果掩码与张量形状推演。
- 位置信息 —— 正弦位置编码、可学习位置编码、RoPE 旋转位置编码与 ALiBi。
- Transformer 块 —— 残差流、Pre-LN 与 Post-LN、前馈网络、GELU 与 SwiGLU、RMSNorm。
- 原始编码器—解码器 Transformer —— 逐段精读 Vaswani et al. (2017),实现一个小型翻译模型。
- 三大模型家族 —— 编码器(BERT)、解码器(GPT)、编码器—解码器(T5)及其预训练目标。
- 从零构建 GPT —— 约 300 行代码实现完整的仅解码器语言模型,并在中文语料上训练。
- 生成与解码 —— 贪心、温度、top-k、top-p 与束搜索;KV 缓存初步。
- 现代架构剖析 —— GQA/MQA、权重共享、Llama 式架构的逐项剖析与消融实验。
- 高效注意力 —— 复杂度分析、FlashAttention 原理(分块与在线 Softmax)、稀疏与线性注意力。
- 可解释性初步 —— 注意力可视化、残差流视角与归纳头。
动手项目
- 从零实现 GPT,在单卡上训练一个约 5000 万参数的中文模型
- 实现 RoPE 并进行长度外推实验
- 把开源 Llama 结构模型的权重加载进自己的实现,验证输出逐位一致
- 做一组架构消融实验(Pre-LN vs Post-LN、GELU vs SwiGLU)
核心阅读
- Vaswani et al. (2017). Attention Is All You Need
- Su et al. (2021). RoFormer: Enhanced Transformer with Rotary Position Embedding
- Shazeer (2020). GLU Variants Improve Transformer
- Ainslie et al. (2023). GQA
- Dao et al. (2022). FlashAttention
- Olsson et al. (2022). In-context Learning and Induction Heads
卷7 GPU 编程与高性能计算
GPU Programming and High-Performance Computing | 估计学时:150 小时 | 规划中
学习目标
- 理解 GPU 体系结构与屋顶线性能模型,能判断计算受限还是内存受限
- 掌握 CUDA 与 Triton 编程,能编写并优化矩阵乘法、融合算子与注意力内核
- 掌握混合精度与低精度数值格式的工程实践
- 掌握 PyTorch 性能分析与优化工具
- 理解集合通信与多机多卡集群的基本原理
先修要求:卷五、卷六;C/C++ 基础;一块 NVIDIA GPU(本地或云端)。
章节安排
- GPU 体系结构 —— SM、线程束、HBM/共享内存/寄存器层次、Tensor Core。
- 性能模型 —— 算力与带宽、屋顶线模型、算术强度。
- CUDA 编程基础 —— 线程/块/网格、内存合并访问、共享内存与同步。
- 矩阵乘法优化 —— 从朴素实现到分块、共享内存与 Tensor Core,逐步逼近 cuBLAS。
- Triton 编程 —— 用 Python 编写高性能内核;融合 Softmax 与 LayerNorm。
- 实现 FlashAttention —— 用 Triton 实现注意力的前向与反向内核。
- 数值格式与混合精度 —— FP16/BF16/FP8、损失缩放与混合精度训练的实现。
- PyTorch 性能工程 —— Profiler、torch.compile、CUDA Graphs 与显存分析。
- 通信基础 —— NCCL 与集合通信(All-Reduce、All-Gather、Reduce-Scatter)、NVLink 与 InfiniBand、通信代价模型。
- 集群与作业 —— 多机多卡环境、作业调度、容错与检查点、成本核算。
动手项目
- CUDA 矩阵乘法逐步优化,达到 cuBLAS 70% 以上的性能
- 用 Triton 实现融合 LayerNorm 与 FlashAttention 前向内核
- 用 Profiler 分析并把一个 GPT 训练脚本提速 2 倍
- 测量并建模 All-Reduce 在不同消息大小下的带宽
核心阅读
- Williams, Waterman & Patterson (2009). Roofline: An Insightful Visual Performance Model. CACM
- Tillet, Kung & Cox (2019). Triton: An Intermediate Language and Compiler for Tiled Neural Network Computations
- Micikevicius et al. (2018). Mixed Precision Training
- Dao (2023). FlashAttention-2
卷8 大语言模型预训练
Pre-training Large Language Models | 估计学时:200 小时 | 规划中
学习目标
- 掌握预训练数据的获取、清洗、去重、过滤与配比
- 从零实现并训练 BPE 分词器
- 理解并应用规模定律进行训练规划与超参数选择
- 掌握数据并行、ZeRO/FSDP、张量并行、流水线并行及其组合
- 能诊断与处理训练不稳定,并在多卡上完成一次 10 亿参数级模型的完整预训练
先修要求:卷六、卷七。
章节安排
- 预训练全景 —— 一次完整预训练的流程、团队分工与成本构成。
- 数据获取与清洗 —— Common Crawl、正文抽取、语言识别、质量过滤、MinHash 去重、隐私与安全过滤。
- 数据配比与课程 —— 网页、代码、数学、书籍与多语言(含中文)数据的配比;数据重复与退火。
- 分词器 —— BPE、Unigram 与字节级 BPE;训练中文友好的分词器;词表大小的权衡。
- 规模定律 —— Kaplan 与 Chinchilla 定律、计算最优、拟合与外推、μP 超参数迁移。
- 训练配方 —— 优化器、学习率调度(warmup-cosine、WSD)、批大小与权重衰减、初始化。
- 训练稳定性 —— 损失尖峰、logit 增长、QK-Norm、z-loss、梯度裁剪、诊断与恢复。
- 数据并行与 ZeRO/FSDP —— DDP、ZeRO-1/2/3、FSDP 实战与显存分析。
- 张量并行与序列并行 —— Megatron 式张量并行、序列并行与上下文并行。
- 流水线并行与多维并行 —— GPipe、1F1B 与交错调度;并行策略的组合与选择。
- 训练基础设施 —— 高效数据加载、检查点、容错、监控与 MFU 优化。
- 中期训练与长上下文扩展 —— RoPE 缩放与长度扩展、领域数据退火。
动手项目
- 从零实现字节级 BPE 分词器并在中英混合语料上训练
- 搭建数据清洗流水线,处理约 10 GB 的中文网页数据
- 用 FSDP 在 8 卡上预训练一个约 10 亿参数的模型
- 在小模型上拟合自己的规模定律曲线并预测更大模型的损失
核心阅读
- Kaplan et al. (2020). Scaling Laws for Neural Language Models
- Hoffmann et al. (2022). Training Compute-Optimal Large Language Models
- Sennrich, Haddow & Birch (2016). Neural Machine Translation of Rare Words with Subword Units
- Shoeybi et al. (2019). Megatron-LM
- Rajbhandari et al. (2020). ZeRO
- Huang et al. (2019). GPipe
- Penedo et al. (2024). The FineWeb Datasets
- Llama Team, AI @ Meta (2024). The Llama 3 Herd of Models. arXiv:2407.21783
卷9 后训练、对齐与推理强化学习
Post-training, Alignment and RL for Reasoning | 估计学时:160 小时 | 规划中
学习目标
- 掌握指令数据构造与监督微调(含 LoRA)
- 理解强化学习基础与 PPO,实现 RLHF 流程
- 掌握 DPO 等偏好优化方法
- 掌握基于可验证奖励的推理强化学习(如 GRPO)
- 理解安全对齐、工具使用与智能体训练的方法
先修要求:卷八(至少完成一个基座模型的预训练或使用开源基座模型)。
章节安排
- 后训练全景 —— 从基座模型到助手模型:SFT、偏好优化与强化学习的分工。
- 指令数据 —— 数据构造、合成数据(Self-Instruct 等)、质量与多样性、对话模板。
- 监督微调 —— 全参数微调、LoRA 与 QLoRA、序列打包与损失掩码。
- 强化学习基础 —— 马尔可夫决策过程、策略梯度、REINFORCE、优势函数与 PPO。
- 奖励模型与 RLHF —— Bradley–Terry 模型、奖励模型训练、PPO-RLHF 实现、奖励黑客。
- 直接偏好优化 —— DPO 推导、IPO、KTO 等变体;在线与离线方法比较。
- 面向推理的强化学习 —— 可验证奖励、GRPO、长思维链的涌现;精读 DeepSeek-R1。
- 推理时计算 —— 自洽性、最佳 N 选一、过程奖励模型与搜索。
- 工具使用与智能体训练 —— 函数调用、多轮交互强化学习、代码执行环境。
- 安全对齐 —— 有用与无害的平衡、拒答校准、宪法式 AI、红队测试与越狱防御。
- 蒸馏与模型合并 —— 推理能力蒸馏、模型合并方法。
动手项目
- 对 10 亿参数基座模型进行 SFT,得到中文对话模型
- 实现 DPO 并与 SFT 模型做对比评测
- 用 GRPO 在数学应用题上训练推理能力并观察回答长度的变化
- 构建一个小型红队测试集并评估模型安全性
核心阅读
- Ouyang et al. (2022). Training Language Models to Follow Instructions with Human Feedback
- Schulman et al. (2017). Proximal Policy Optimization Algorithms
- Rafailov et al. (2023). Direct Preference Optimization
- Shao et al. (2024). DeepSeekMath(提出 GRPO)
- DeepSeek-AI (2025). DeepSeek-R1
- Hu et al. (2022). LoRA
- Bai et al. (2022). Constitutional AI
卷10 推理优化、部署与评测
Inference Optimization, Deployment and Evaluation | 估计学时:120 小时 | 规划中
学习目标
- 理解 LLM 推理的计算特性与性能瓶颈
- 掌握 KV 缓存、量化、投机解码与连续批处理等推理优化技术
- 能部署高吞吐、低延迟的模型服务
- 建立科学的大模型评测方法论,覆盖能力、安全与可靠性
先修要求:卷六至卷九。
章节安排
- 推理的计算特性 —— 预填充与解码、计算受限与内存受限、延迟与吞吐的权衡。
- KV 缓存 —— 原理与显存估算、PagedAttention、前缀缓存。
- 量化 —— INT8/INT4、GPTQ、AWQ、FP8 推理、KV 缓存量化。
- 解码加速 —— 投机解码、多头草稿解码、多词元预测。
- 批处理与调度 —— 连续批处理、预填充/解码分离、主流推理引擎架构剖析。
- 分布式推理 —— 张量并行推理、专家并行、长上下文推理。
- 端侧与本地部署 —— llama.cpp、GGUF 格式与移动端推理。
- 评测方法论 —— 基准设计、数据污染检测、统计显著性、LLM-as-a-Judge 及其偏差。
- 能力评测 —— 知识、推理、数学、代码、长上下文与多语言(含中文)评测。
- 安全与可靠性评测 —— 幻觉、偏见、越狱与红队;线上监控与 A/B 测试。
动手项目
- 从零实现带 KV 缓存与连续批处理的推理引擎
- 实现 INT4 权重量化并测量精度损失
- 实现投机解码并测量加速比
- 为自己训练的模型搭建一套自动化评测流水线
核心阅读
- Kwon et al. (2023). Efficient Memory Management for LLM Serving with PagedAttention
- Leviathan, Kalman & Matias (2023). Fast Inference from Transformers via Speculative Decoding
- Frantar et al. (2023). GPTQ
- Lin et al. (2024). AWQ
- Zheng et al. (2023). Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena
- Hendrycks et al. (2021). Measuring Massive Multitask Language Understanding
卷11 前沿专题:MoE、长上下文、多模态与智能体
Frontiers: MoE, Long Context, Multimodality and Agents | 估计学时:100 小时 | 规划中
学习目标
- 理解并实现混合专家模型与专家并行
- 掌握长上下文建模与状态空间模型等新架构
- 理解视觉—语言等多模态模型与扩散模型
- 理解智能体系统的设计与评测
- 学会跟踪前沿、复现论文并开展独立研究
先修要求:卷六至卷十。
章节安排
- 混合专家模型 —— 稀疏门控、负载均衡、专家并行;Switch Transformer、Mixtral 与 DeepSeek-MoE。
- 长上下文 —— 位置外推、滑动窗口与稀疏注意力、环形注意力;状态空间模型(Mamba)与混合架构。
- 多模态 —— ViT、CLIP、视觉—语言模型、语音与全模态模型。
- 扩散模型与生成 —— DDPM、潜空间扩散与扩散 Transformer(DiT)。
- 智能体 —— 规划、记忆与工具使用;编程智能体与多智能体系统及其评测。
- 合成数据与自我改进 —— 数据合成、自我博弈与“数据墙”问题。
- 可解释性与对齐研究 —— 机制可解释性、稀疏自编码器、可扩展监督。
- 高效训练前沿 —— FP8/FP4 训练、低通信分布式优化与新型优化器。
- 如何做研究 —— 读论文、复现、提出好问题、写作与开源。
动手项目
- 实现 Top-k MoE 层并分析负载均衡损失的作用
- 训练一个小型 CLIP 或视觉—语言模型
- 构建一个能读写代码并运行测试的编程智能体
- 复现一篇近期论文的核心实验
核心阅读
- Shazeer et al. (2017). Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer
- Fedus, Zoph & Shazeer (2022). Switch Transformers. JMLR
- Gu & Dao (2023). Mamba
- Dosovitskiy et al. (2021). An Image is Worth 16x16 Words (ViT)
- Radford et al. (2021). Learning Transferable Visual Models From Natural Language Supervision (CLIP)
- Ho, Jain & Abbeel (2020). Denoising Diffusion Probabilistic Models
- Peebles & Xie (2023). Scalable Diffusion Models with Transformers
- Yao et al. (2023). ReAct
六、毕业项目
贯穿卷八至卷十的毕业项目:从零训练一个约 10 亿参数的中文对话与推理模型。
- 卷八:自建分词器与数据流水线,在 8 卡集群上用 FSDP 完成约 200 亿词元的预训练,并记录完整的训练日志与规模定律分析;
- 卷九:对基座模型进行 SFT、DPO 与 GRPO 推理强化学习,得到能进行多轮对话并解答中文数学应用题的模型;
- 卷十:用自己实现的推理引擎部署模型,并发布一份包含能力与安全评测的技术报告。
七、硬件建议
| 阶段 | 建议硬件 |
|---|---|
| 卷一至卷四 | 普通笔记本电脑(CPU 即可) |
| 卷五、卷六 | 一块 GPU(如显存 16–24 GB 的消费级显卡,或按小时租用的云 GPU) |
| 卷七 | 一块较新的 NVIDIA GPU(支持 Tensor Core 与 BF16) |
| 卷八至卷十 | 多卡环境:开发阶段 1–2 卡;毕业项目建议短期租用 8 卡数据中心 GPU 服务器 |
| 卷十一 | 视选题而定;大多数专题实验可在 1–8 卡上完成 |
八、说明
- 本总纲中列出的论文均为真实发表的经典工作,年份以正式发表为准;各卷正文会给出完整的参考文献信息。
- 工具与框架迭代很快,各卷以讲透原理为主,以当时的主流工具为实践载体。
- 卷一已完成(在线阅读),其余各卷按路线图顺序编写。