机器学习核心概念
前面六章,我们沿着时间线走完了 AI 七十余年的历史。从本章开始,我们换一个视角:不再问“发生了什么”,而是问“它是怎么工作的”。本章介绍机器学习最核心的概念框架。无论是 1958 年的感知机,还是 2025 年的千亿参数大模型,都可以用本章的语言来描述:数据、模型、损失函数、优化算法、泛化。把这套框架内化为直觉,是后续所有学习的基础。
机器学习的基本范式
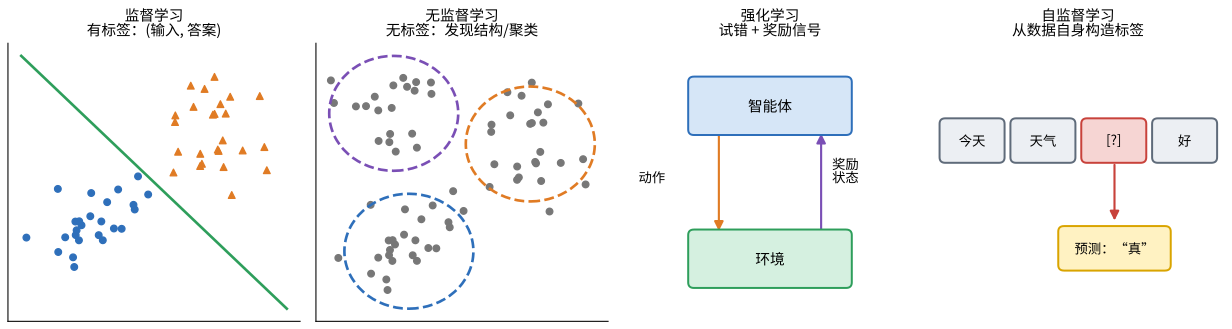
根据训练时可以获得什么样的“监督信号”,机器学习通常分为以下几种范式(图 8.1)。
监督学习
监督学习 (Supervised Learning) 的训练数据由“输入—标签”对 \(\left( \mathbf{x}_{i},y_{i} \right)\) 组成,目标是学习一个函数 \(f\),使得 \(f\left( \mathbf{x} \right) \approx y\)。根据标签的类型又可分为:
-
分类 (Classification):标签是离散的类别,如“垃圾邮件/正常邮件”、“猫/狗/鸟”;
-
回归 (Regression):标签是连续的数值,如房价、气温。
监督学习是最成熟、应用最广的范式。它的主要瓶颈是标注成本:ImageNet 的标注动用了数万名众包工作者,医学影像的标注更是需要昂贵的专家时间。
无监督学习
无监督学习 (Unsupervised Learning) 只有输入 \(\mathbf{x}_{i}\),没有标签,目标是发现数据中的结构。典型任务包括聚类 (Clustering,如把用户分成若干群体)、降维 (Dimensionality Reduction,如把高维数据压缩到二维以便可视化) 和密度估计 (Density Estimation,估计数据的概率分布)。
强化学习
强化学习 (Reinforcement Learning, RL) 中,智能体通过与环境交互、试错来学习。它不会被告知“正确的动作是什么”,只会在一段时间后得到奖励 (Reward) 信号,需要自己弄清楚哪些动作导致了好的结果。AlphaGo、机器人控制,以及大模型的 RLHF 和推理训练都属于强化学习。经典教材是萨顿和巴托 (Andrew Barto) 的《强化学习》(Sutton & Barto, 2018);二人因此获得了 2024 年度图灵奖。
自监督学习
自监督学习 (Self-Supervised Learning) 是大模型时代最重要的范式。它从数据本身构造监督信号:遮住句子中的一个词让模型预测(BERT),或者让模型预测下一个词(GPT),或者遮住图片的一部分让模型补全。形式上它像监督学习(有输入和标签),但标签无需人工标注,因此可以利用海量的无标签数据。可以说,自监督学习解决了监督学习的标注瓶颈,是大模型能够“大”的前提。
表 8.1 四种学习范式对比,以及它们在大模型训练流程中的位置
| 范式 | 训练数据 | 学习目标 | 大模型中的角色 |
|---|---|---|---|
| 监督学习 | (输入, 人工标签) | 预测标签 | 监督微调 (SFT) |
| 无监督学习 | 只有输入 | 发现结构 | 数据去重、聚类与筛选 |
| 强化学习 | 交互经验 + 奖励 | 最大化累积奖励 | RLHF、推理能力训练 |
| 自监督学习 | 只有输入(自动构造标签) | 预测数据的被遮挡部分 | 预训练 |
机器学习的工作流程
一个机器学习项目通常遵循如 图 8.2 所示的迭代流程。
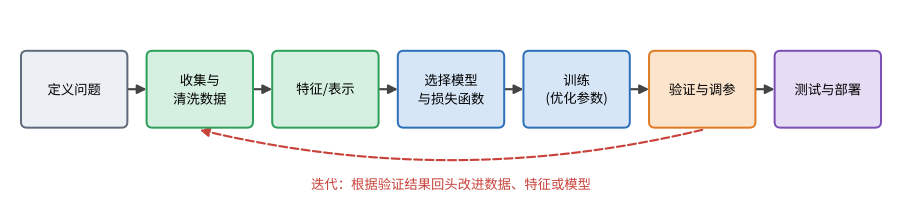
新手往往把大部分精力花在“选择模型”上,但有经验的工程师知道,数据的质量和数量往往比模型的选择更重要。在大模型训练中更是如此:顶尖团队花在数据收集、清洗、去重、过滤和配比上的精力,常常超过花在模型结构上的精力。
训练集、验证集与测试集
机器学习的终极目标不是在已有数据上表现好,而是在从未见过的新数据上表现好,这种能力称为 泛化 (Generalization)。为了评估泛化能力,我们把数据分成三部分:
-
训练集 (Training Set):用于学习模型参数;
-
验证集 (Validation Set):用于选择超参数(如学习率、模型大小)和决定何时停止训练;
-
测试集 (Test Set):只在最终评估时使用一次,用来估计模型在真实世界中的表现。
数据泄漏
测试集必须严格与训练过程隔离。如果你根据测试集的结果反复调整模型,测试集实际上就变成了验证集,最终报告的性能将过于乐观。在大模型时代,这个问题以新的形式出现:测试题可能出现在从互联网上爬取的预训练数据中,这称为数据污染 (Data Contamination)。评估大模型时,必须警惕这种情况。
当数据量较少时,可以使用 k 折交叉验证 (k-fold Cross-Validation):把训练数据分成 \(k\) 份,轮流用其中一份作验证、其余 \(k - 1\) 份作训练,最后取 \(k\) 次结果的平均值。
三要素:模型、损失与优化
几乎所有机器学习方法都可以分解为三个要素:
-
模型 (Model):一个带参数 \(\theta\) 的函数族 \(f_{\theta}\left( \mathbf{x} \right)\),定义了“可能学到什么”。例如线性模型 \(f\left( \mathbf{x} \right) = \mathbf{w}^{\top}\mathbf{x} + b\),或者有数千亿参数的 Transformer。
-
损失函数 (Loss Function):衡量预测 \(\hat{y} = f_{\theta}\left( \mathbf{x} \right)\) 与真实值 \(y\) 之间差距的函数 \(\ell(\hat{y},y)\),定义了“什么是好”。训练的目标是最小化训练集上的平均损失:
\[ \mathcal{L}(\theta) = \frac{1}{n}\sum_{i = 1}^{n}\ell(f_{\theta}\left( \mathbf{x}_{i} \right),y_{i}) \tag{8.1} \]这称为经验风险最小化 (Empirical Risk Minimization)。
-
优化算法 (Optimizer):寻找使损失最小的参数 \(\theta^{\ast} = \arg\min\limits_{\theta}\mathcal{L}(\theta)\) 的方法,定义了“如何学”。深度学习中几乎总是使用梯度下降及其变体。
常见的损失函数有:回归问题的均方误差 (Mean Squared Error, MSE) \(\ell = \left( \hat{y} - y \right)^{2}\);分类问题的交叉熵损失,即对正确类别的预测概率取负对数 \(\ell = - \log{\hat{p}}_{y}\)。大语言模型的预训练损失(式 (7.2))正是交叉熵。
一个完整的例子:线性回归
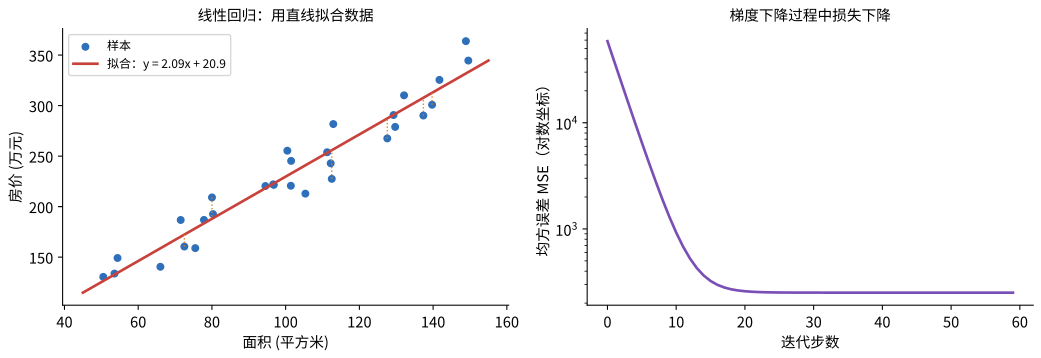
让我们用最简单的模型——线性回归 (Linear Regression)——把三要素串起来。假设我们想根据房屋面积 \(x\) 预测房价 \(y\)。
-
模型:\(\hat{y} = wx + b\),参数为 \(\theta = (w,b)\);
-
损失:均方误差 \(\mathcal{L}(w,b) = \frac{1}{n}\sum_{i = 1}^{n}\left( wx_{i} + b - y_{i} \right)^{2}\);
-
优化:梯度下降。
解析解
对于线性回归,可以直接用微积分求出最优解。令损失对 \(w\) 和 \(b\) 的偏导数为零,可得:
其中 \(\overline{x}\) 和 \(\overline{y}\) 分别是 \(x\) 和 \(y\) 的均值。这称为最小二乘法 (Least Squares),由高斯和勒让德在 19 世纪初提出——机器学习的历史,某种意义上比计算机还要古老。
例题 手算线性回归
给定三个样本:\((1,2)\)、\((2,4)\)、\((3,5)\)。
解析解:\(\overline{x} = 2\),\(\overline{y} = \frac{11}{3} \approx 3.667\)。分子为 \(( - 1)( - 1.667) + 0 \cdot 0.333 + 1 \cdot 1.333 = 3\),分母为 \(1 + 0 + 1 = 2\),所以 \(w^{\ast} = 1.5\),\(b^{\ast} = 3.667 - 1.5 \times 2 \approx 0.667\)。三个预测值为 \(2.167,3.667,5.167\),均方误差约为 \(0.056\)。
梯度下降的一步:从 \(w = 0,b = 0\) 出发,此时所有预测为 0,损失为 \((4 + 16 + 25)/3 = 15\)。梯度为
取学习率 \(\eta = 0.1\),更新后 \(w = 0 - 0.1 \times ( - 16.67) \approx 1.667\),\(b \approx 0.733\)。新的预测为 \(2.40,4.07,5.73\),损失降至约 \(0.234\)——一步就从 15 降到了 0.23。继续迭代,参数将收敛到解析解 \((1.5,0.667)\)。
梯度下降
为什么要用梯度下降,而不总是用解析解?因为对于神经网络这样的复杂模型,根本不存在解析解。梯度下降 (Gradient Descent) 是一种通用的迭代方法:
其中 \(\nabla_{\theta}\mathcal{L}\) 是损失对参数的梯度,指向损失增长最快的方向;沿其反方向走一小步,损失就会下降。\(\eta\) 是学习率,控制步长。
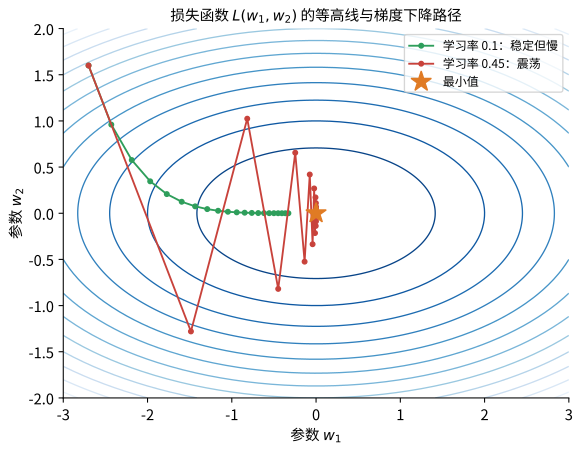
学习率的选择至关重要(图 8.4):太小则收敛缓慢;太大则会在最优点附近来回震荡,甚至发散。在训练大模型时,学习率通常先从零预热 (Warmup) 增长到峰值,再按余弦曲线逐渐衰减——这些技巧将在卷五和卷八中详细讨论。
实际中,计算整个训练集上的梯度太昂贵(大模型的训练集有数万亿词元),因此每次只用一小批 (Mini-batch) 样本估计梯度,这称为 随机梯度下降 (Stochastic Gradient Descent, SGD)。用 NumPy 实现线性回归的梯度下降只需要几行代码:
import numpy as np

rng = np.random.default_rng(0)
x = rng.uniform(50, 150, size=100)                 # 面积(平方米)
y = 2.0 * x + 30 + rng.normal(0, 18, size=100)     # 房价(万元),含噪声
x_n = (x - x.mean()) / x.std()                     # 标准化,让梯度下降更稳定

w, b, lr = 0.0, 0.0, 0.1
for step in range(200):
    y_hat = w * x_n + b
    grad_w = 2 * np.mean((y_hat - y) * x_n)        # ∂L/∂w
    grad_b = 2 * np.mean(y_hat - y)                # ∂L/∂b
    w, b = w - lr * grad_w, b - lr * grad_b
    if step % 50 == 0:
        print(f"step {step:3d}  MSE = {np.mean((y_hat - y) ** 2):9.2f}")

# 换算回原始尺度:y = (w/σ)·x + (b - w·μ/σ)
print("斜率", w / x.std(), "截距", b - w * x.mean() / x.std())
提示
代码中对输入做了标准化(减去均值、除以标准差)。如果不这样做,面积的数值在 100 左右,而偏置对应的“输入”是 1,两个参数的梯度量级相差悬殊,梯度下降会非常缓慢甚至发散。数据预处理和数值稳定性是机器学习工程中极其重要的话题,在大模型训练中(如混合精度训练)会以更复杂的形式出现。
欠拟合、过拟合与泛化
两种失败
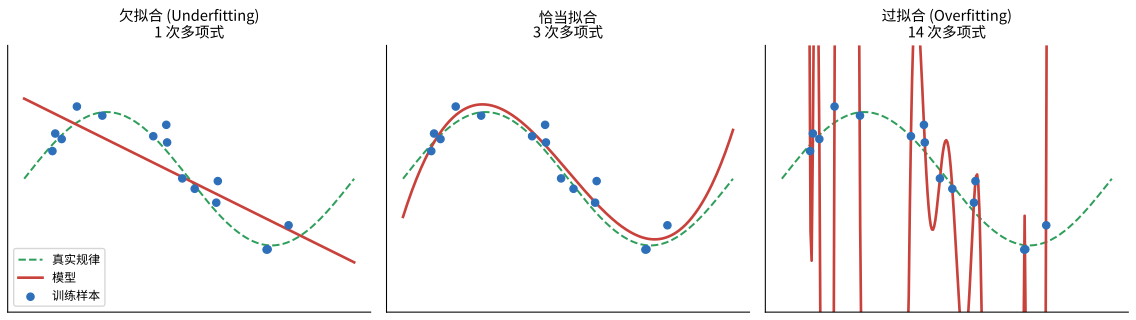
模型可能以两种相反的方式失败(图 8.5):
-
欠拟合 (Underfitting):模型太简单,无法捕捉数据中的规律,在训练集和测试集上都表现不好。
-
过拟合 (Overfitting):模型太复杂,不仅学到了规律,还“记住”了训练数据中的噪声,在训练集上表现极好,在新数据上却表现很差。
偏差—方差权衡
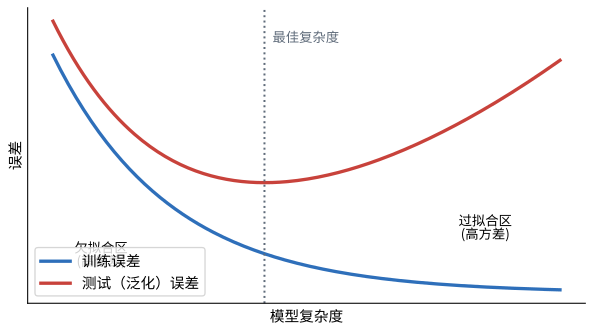
经典理论用 偏差—方差权衡 (Bias-Variance Tradeoff) 来解释这一现象。偏差 (Bias) 来自模型假设与真实规律之间的系统性差距(模型太简单);方差 (Variance) 来自模型对训练数据中随机波动的敏感程度(模型太复杂)。随着模型复杂度增加,偏差下降而方差上升,测试误差呈现 U 形曲线(图 8.6)。
思考
按照 图 8.6,模型越大越容易过拟合。但大语言模型的参数量高达数千亿,为什么反而越大越好?这是一个深刻的问题。部分答案是:大模型的训练数据也极其庞大(数万亿词元),通常只训练一到几个轮次,模型很难“记住”所有数据;此外,研究者还观察到了“双下降”(Double Descent) 等经典理论无法解释的现象。现代深度学习的泛化理论仍是一个活跃的研究领域。
对抗过拟合的手段
常用的方法包括:获取更多数据(最有效但往往最贵);正则化 (Regularization),例如在损失中加入权重大小的惩罚项 \(\lambda\|\mathbf{w}\|^{2}\)(称为 L2 正则化或权重衰减,Weight Decay);Dropout;早停 (Early Stopping),即在验证集误差开始上升时停止训练;以及数据增强。
评估指标
选择正确的评估指标与训练模型同样重要。对于分类问题,最直观的指标是准确率 (Accuracy),即预测正确的样本比例。但在类别不平衡时,准确率可能具有严重的误导性。
例题 欺诈检测的评估
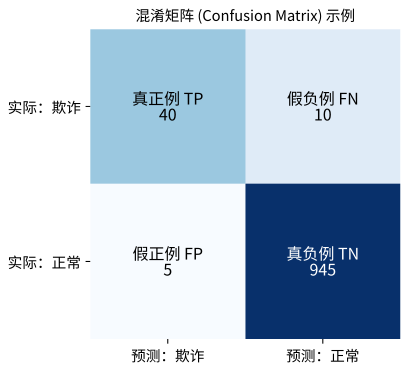
图 8.7 中,1000 笔交易里有 50 笔是欺诈。模型预测的结果为:真正例 TP = 40,假负例 FN = 10,假正例 FP = 5,真负例 TN = 945。
-
准确率 = (TP + TN) / 总数 = (40 + 945) / 1000 = 98.5%;
-
精确率 (Precision) = TP / (TP + FP) = 40 / 45 ≈ 88.9%,即“报警的交易中真正是欺诈的比例”;
-
召回率 (Recall) = TP / (TP + FN) = 40 / 50 = 80%,即“所有欺诈中被抓住的比例”;
-
F1 分数 = 2 × 精确率 × 召回率 / (精确率 + 召回率) ≈ 0.842。
对比一个永远预测“正常”的无用模型:它的准确率高达 950 / 1000 = 95%,但召回率为 0——一笔欺诈也抓不到。可见在不平衡数据上,只看准确率是远远不够的。
大语言模型的评估更加复杂:预训练阶段看困惑度 (Perplexity,交叉熵损失的指数);能力评估使用各种基准测试 (Benchmark),如知识问答、数学推理和代码生成;对话质量则常常需要人类或更强的模型进行评判。卷十将系统讨论大模型评测。
没有免费的午餐
最后介绍一个发人深省的理论结果:没有免费的午餐定理 (No Free Lunch Theorem) (Wolpert & Macready, 1997)。粗略地说,它表明如果对所有可能的问题取平均,任何学习算法的表现都不会比随机猜测更好。换句话说,不存在在所有问题上都最优的“万能算法”。
这听起来令人沮丧,但它的实际含义是:每个成功的学习算法都隐含了对问题的某种假设,这种假设称为归纳偏置 (Inductive Bias)。卷积网络假设图像具有局部性和平移不变性;循环网络假设序列按顺序处理;Transformer 的归纳偏置相对较弱,这使它需要更多数据,但也让它更通用、更容易随规模扩展。理解每种模型的归纳偏置,是选择和设计模型的关键。
本章小结
-
机器学习的四种范式:监督学习(有标签)、无监督学习(无标签,找结构)、强化学习(奖励信号)、自监督学习(从数据自身构造标签,是大模型预训练的基础)。
-
机器学习项目是一个迭代循环;数据质量常常比模型选择更重要。训练集、验证集和测试集必须严格分开,警惕数据泄漏和数据污染。
-
三要素:模型(函数族)、损失函数(什么是好)、优化算法(如何学)。训练就是经验风险最小化。
-
梯度下降沿梯度反方向更新参数,学习率是最关键的超参数;实际中使用小批量随机梯度下降。
-
欠拟合与过拟合是两种相反的失败;偏差—方差权衡是经典解释,但大模型的泛化现象超出了经典理论。
-
在不平衡数据上应关注精确率、召回率和 F1,而不只是准确率。
-
没有免费的午餐:每种算法都有其归纳偏置。
习题
-
(概念) 判断下列任务分别属于哪种学习范式:(a) 根据历史数据预测明天的股价;(b) 把新闻文章自动分成若干主题;(c) 训练机器人学会走路;(d) 用维基百科文本训练模型预测被遮住的词。
-
(计算) 对样本 \((0,1)\)、\((1,3)\)、\((2,5)\)、\((3,7)\),用式 (8.2) 求线性回归的最优参数,并计算均方误差。
-
(计算) 对上一题的数据,从 \(w = 0,b = 0\) 出发,用学习率 \(\eta = 0.05\) 手算一步梯度下降后的参数值。
-
(编程) 修改本章的梯度下降代码,分别尝试学习率 0.01、0.1、0.5 和 1.1,记录 200 步后的损失。哪个学习率导致了发散?
-
(计算) 某疾病筛查模型在 10000 人中检测:实际患病 100 人,模型检出其中 90 人;实际健康的 9900 人中,有 495 人被误报为阳性。计算准确率、精确率、召回率和 F1。
-
(概念) 为什么测试集只能在最终评估时使用一次?如果在开发过程中反复查看测试集结果,会发生什么?
-
(思考) 举例说明卷积神经网络的归纳偏置。为什么 Transformer 的归纳偏置较弱反而可能成为优势?
延伸阅读
-
Bishop, C. M. (2006). Pattern Recognition and Machine Learning. Springer. 第 1 章。
-
李航 (2019).《统计学习方法》(第 2 版). 清华大学出版社.
-
Sutton, R. S., & Barto, A. G. (2018). Reinforcement Learning: An Introduction (2nd ed.). MIT Press.
-
Wolpert, D. H., & Macready, W. G. (1997). No Free Lunch Theorems for Optimization. IEEE Transactions on Evolutionary Computation, 1(1), 67–82.