专家系统、联结主义复兴与第二次寒冬:1980—1993
第一次寒冬让 AI 研究者意识到,追求“通用”的推理方法可能是一条死路。一个新的思路逐渐成形:智能的关键不在于聪明的推理算法,而在于大量的专门知识。斯坦福大学的爱德华·费根鲍姆 (Edward Feigenbaum) 把这一思想概括为“知识就是力量”。它催生了 AI 的第一次商业繁荣——专家系统 (Expert System)。与此同时,在主流视野之外,神经网络研究也悄然复苏,反向传播算法让训练多层网络成为可能。本章讲述这两条线索,以及随之而来的第二次寒冬。
专家系统的原理
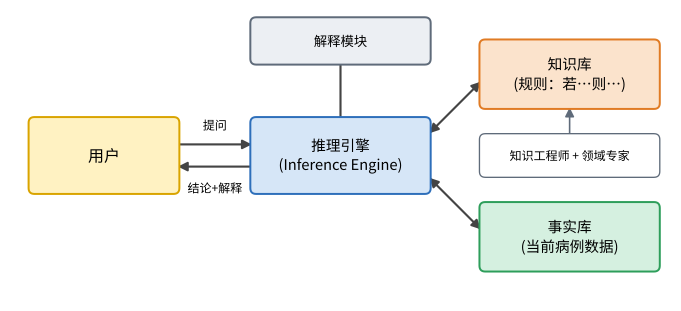
专家系统试图把人类专家在某一狭窄领域(如医学诊断、地质勘探、设备配置)中的知识编码成计算机可用的形式,然后通过推理来回答问题。一个典型专家系统的架构如 图 4.1 所示。
-
知识库 (Knowledge Base):以“如果(条件)那么(结论)”形式的产生式规则 (Production Rule) 存储领域知识。
-
事实库 (Working Memory):存放当前问题的具体事实,如某个病人的症状和化验结果。
-
推理引擎 (Inference Engine):反复匹配规则与事实,推导出新事实,直到得出结论。常用的策略有正向链接 (Forward Chaining,从事实出发推出结论) 和反向链接 (Backward Chaining,从假设目标出发寻找支持证据)。
-
解释模块:回答“你为什么得出这个结论?”——这是专家系统相对于神经网络的一大优势。
-
知识库的内容来自知识工程师 (Knowledge Engineer) 与领域专家的反复访谈。
例题 正向链接推理
知识库中有以下规则:
-
R1:如果 发烧 且 咳嗽,那么 疑似呼吸道感染;
-
R2:如果 疑似呼吸道感染 且 肺部有阴影,那么 疑似肺炎;
-
R3:如果 疑似肺炎 且 年龄大于 65,那么 建议住院。
已知事实:{发烧,咳嗽,肺部有阴影,年龄大于 65}。正向链接的过程是:第一轮 R1 被触发,加入“疑似呼吸道感染”;第二轮 R2 的条件满足,加入“疑似肺炎”;第三轮 R3 被触发,加入“建议住院”;第四轮没有新规则可以触发,推理结束。解释模块可以回放这条推理链:建议住院 ← R3 ← 疑似肺炎 ← R2 ← 疑似呼吸道感染 ← R1。
对应的 Python 实现:
rules = [
    ({"发烧", "咳嗽"}, "疑似呼吸道感染"),
    ({"疑似呼吸道感染", "肺部有阴影"}, "疑似肺炎"),
    ({"疑似肺炎", "年龄大于65"}, "建议住院"),
]

def forward_chain(facts, rules):
    facts, trace = set(facts), []
    changed = True
    while changed:                      # 直到没有新事实产生
        changed = False
        for cond, concl in rules:
            if cond <= facts and concl not in facts:
                facts.add(concl)
                trace.append(f"{' 且 '.join(sorted(cond))} => {concl}")
                changed = True
    return facts, trace

facts, trace = forward_chain({"发烧", "咳嗽", "肺部有阴影", "年龄大于65"}, rules)
print("\n".join(trace))
代表性的专家系统
DENDRAL 与 MYCIN
DENDRAL 项目从 1965 年开始在斯坦福进行,由费根鲍姆、诺贝尔奖得主遗传学家莱德伯格 (Joshua Lederberg) 和布坎南 (Bruce Buchanan) 等人主导。它根据质谱仪数据推断有机化合物的分子结构,表现可与化学专家媲美,通常被认为是第一个成功的专家系统。
MYCIN 是 20 世纪 70 年代斯坦福开发的医疗诊断系统,用于识别引起严重感染的细菌并推荐抗生素 (Shortliffe, 1976)。它包含约 600 条规则,并引入了确定性因子 (Certainty Factor) 来处理医学中的不确定性。在一项对比评估中,MYCIN 的治疗建议质量不逊于斯坦福医学院的传染病专家。然而,MYCIN 从未在临床中正式使用——原因包括法律责任问题、与医院工作流程的集成困难,以及医生对“机器诊断”的不信任。这些非技术障碍,在今天的医疗 AI 中依然存在。
XCON:第一次商业成功
真正让专家系统走向商业的是 XCON(最初名为 R1)。它由卡内基梅隆大学的麦克德莫特 (John McDermott) 为数字设备公司 (DEC) 开发,自 1980 年起用于根据客户订单自动配置 VAX 计算机系统的组件 (McDermott, 1982)。XCON 最终包含数千条规则,据报道每年为 DEC 节省数千万美元。
XCON 的成功引发了一轮投资热潮。到 20 世纪 80 年代中期,大多数财富 500 强公司都在开发或使用专家系统;专门运行 Lisp 的 Lisp 机 (Lisp Machine) 公司如 Symbolics 等应运而生。1982 年,日本通产省启动了雄心勃勃的第五代计算机项目,计划用十年时间研制以逻辑编程语言 Prolog 为基础的智能计算机。美国和英国也相继推出了大规模的 AI 资助计划作为回应。
Cyc:编码全部常识
如果说专家系统编码的是“专门知识”,那么 1984 年道格拉斯·莱纳特 (Douglas Lenat) 启动的 Cyc 项目则试图编码人类的全部常识——比如“水往低处流”“人不能同时出现在两个地方”。Cyc 持续进行了几十年,手工录入了数百万条断言,却始终没有成为通用智能的基础。Cyc 的经历是对“知识需要人工编写”这一路线最有力的反思:常识的数量几乎是无穷的,而且大多是隐性的,很难用明确的规则写下来。今天的大语言模型从海量文本中“吸收”常识,可以看作对这一难题的另一种回答。
第二次 AI 寒冬
专家系统的繁荣没有持续太久。到 20 世纪 80 年代末,它的根本缺陷逐渐暴露:
-
知识获取瓶颈 (Knowledge Acquisition Bottleneck):专家往往说不清自己是怎么做判断的,把知识转化为规则既昂贵又缓慢。
-
脆弱性 (Brittleness):系统只在规则覆盖的范围内有效,遇到稍微超出范围的情况就会给出荒谬的答案,而且它“不知道自己不知道”。
-
维护困难:规则数量增加到数千条后,规则之间的冲突和相互作用变得难以管理,修改一条规则可能引发意想不到的连锁反应。
-
无法学习:系统不能从新的案例中自动改进,所有更新都依赖人工。
-
硬件市场崩溃:1987 年前后,苹果和 IBM 的通用台式机性能迅速提升,价格昂贵的专用 Lisp 机失去了市场,相关公司纷纷倒闭。
日本第五代计算机项目在 1992 年结束时也未能达到最初设定的目标。投资者和政府再次失去信心,AI 迎来了第二次寒冬(约 1987—1993 年)。在这一时期,许多研究者甚至刻意避免使用“人工智能”这个词,转而称自己的工作为“信息学”“知识系统”或“计算智能”。
历史的教训
专家系统的失败不是因为“规则”这种方法毫无价值——今天的业务规则引擎、编译器优化规则、静态代码分析工具依然在大量使用规则。真正的教训是:依赖人工编码知识的方法难以随问题规模扩展。这正是 Sutton《苦涩的教训》的核心观点,也是理解为什么数据驱动的方法最终胜出的关键。
符号主义与联结主义
到这里,我们已经见识了 AI 的两大流派。图 4.2 总结了它们的主要差异。
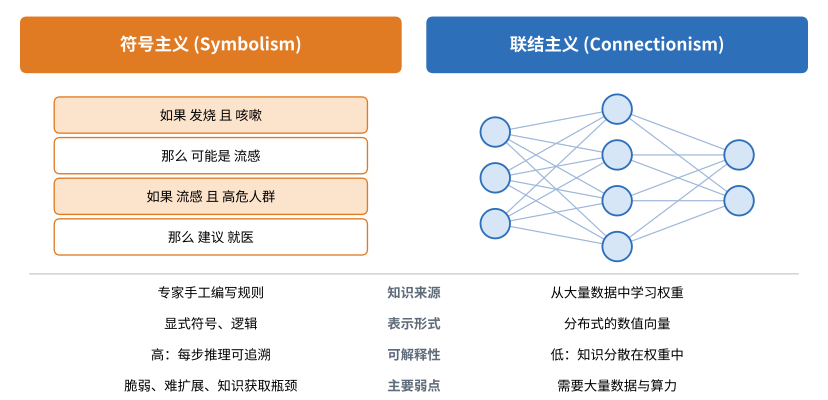
符号主义认为智能源于对显式符号的操作:知识以逻辑规则的形式由人编写,推理过程透明可解释。联结主义 (Connectionism) 则认为智能源于大量简单单元(神经元)之间的连接:知识以权重的形式分布式地存储在网络中,通过学习从数据中获得。
这两个流派之间的争论贯穿了整个 AI 史。今天,联结主义(深度学习)在大多数任务上占据了绝对优势,但符号主义的某些思想正在以新的形式回归:大语言模型调用代码解释器、搜索引擎和计算器等“工具”,进行一步步的显式推理(思维链),本质上都是在神经网络中融合符号化的操作。如何把二者的优点结合起来——神经符号 (Neuro-symbolic) AI——依然是一个活跃的研究方向。
联结主义的暗流
在专家系统风光无限的 20 世纪 80 年代,一小群研究者坚持研究神经网络,并取得了几项关键突破。
Hopfield 网络与玻尔兹曼机
1982 年,物理学家约翰·霍普菲尔德 (John Hopfield) 提出了一种全连接的递归神经网络,后称 Hopfield 网络 (Hopfield, 1982)。他借用统计物理中的“能量”概念,证明网络的状态更新总会使能量下降,最终收敛到能量的局部极小值。这些极小值可以用来存储“记忆”——给网络一个残缺或带噪声的输入,它会自动恢复出最接近的完整记忆,这称为联想记忆。随后,杰弗里·辛顿 (Geoffrey Hinton) 和特伦斯·谢诺夫斯基 (Terrence Sejnowski) 等人提出了带有随机性的 玻尔兹曼机 (Boltzmann Machine) (Ackley, Hinton & Sejnowski, 1985)。霍普菲尔德与辛顿因“为利用人工神经网络进行机器学习奠定基础的发现和发明”,共同获得了 2024 年诺贝尔物理学奖。
反向传播
前面说过,《感知机》指出的真正难题是:如何训练多层网络?多层网络中,中间层(隐藏层,Hidden Layer)的神经元没有直接的“正确答案”,我们不知道该如何调整它们的权重——这被称为信用分配问题 (Credit Assignment Problem)。
答案是 反向传播 (Backpropagation) 算法。它的数学核心——用链式法则高效计算复合函数对每个参数的导数,即反向模式自动微分——在 1970 年就由芬兰学者林纳因马 (Seppo Linnainmaa) 在其硕士论文中提出,保罗·韦伯斯 (Paul Werbos) 在 1974 年的博士论文中也提出了将其用于训练神经网络的想法。但真正让这一方法广为人知的,是 1986 年鲁梅尔哈特 (David Rumelhart)、辛顿和威廉姆斯 (Ronald Williams) 发表在《自然》杂志上的论文《通过反向传播误差学习表示》(Rumelhart, Hinton & Williams, 1986)。
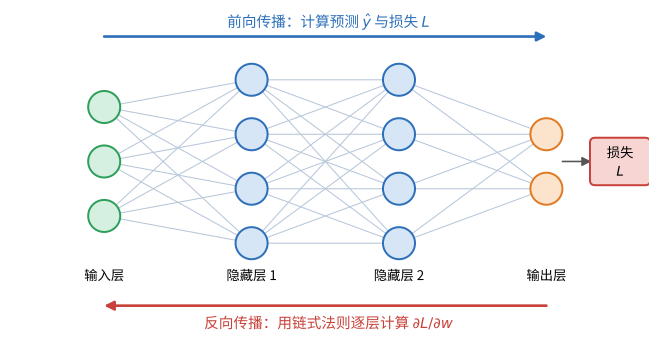
反向传播的思路如 图 4.3 所示:
-
前向传播 (Forward Pass):输入逐层经过网络,得到预测 \(\hat{y}\),并计算它与真实值 \(y\) 之间的损失 (Loss) \(L\)。
-
反向传播 (Backward Pass):从损失出发,利用微积分的链式法则 (Chain Rule),从输出层向输入层逐层计算损失对每个权重的偏导数 \(\partial L/\partial w\),即梯度 (Gradient)。
-
参数更新:沿梯度的反方向微调每个权重,使损失减小——这就是梯度下降 (Gradient Descent)。
关键的一步是把感知机中不可导的阶跃函数换成平滑可导的 Sigmoid 函数 \(\sigma(z) = 1/\left( 1 + e^{- z} \right)\),这样梯度才能“流过”每一层。1986 年论文最令人兴奋的发现是:隐藏层会自动学到有意义的内部表示——网络自己发现了任务所需的特征,而不需要人工设计。“学习表示”(Learning Representations) 这个思想,正是后来深度学习的灵魂。
同年,鲁梅尔哈特和麦克莱兰 (James McClelland) 等人出版了两卷本的《并行分布式处理》(Parallel Distributed Processing),系统阐述了联结主义的理论框架,在认知科学界引起轰动。
提示
反向传播是本系列最重要的算法之一。本章只介绍直觉;第 9 章会用一个具体的数值例子手算一遍;卷二会从矩阵微积分的角度严格推导;卷五则会带你从零实现一个自动微分引擎。今天的 PyTorch 中,一行 loss.backward() 背后就是这个算法。
万能近似与卷积网络
1989 年,西本科 (George Cybenko) 以及霍尼克 (Kurt Hornik) 等人分别证明了 万能近似定理 (Universal Approximation Theorem):只含一个隐藏层的前馈网络,只要隐藏神经元足够多,就能以任意精度逼近任何连续函数 (Cybenko, 1989; Hornik, Stinchcombe & White, 1989)。这为神经网络的表达能力提供了理论保证——尽管它没有告诉我们需要多少神经元,也没有告诉我们如何找到这些权重。
同样在 1989 年,贝尔实验室的杨立昆 (Yann LeCun) 等人将反向传播用于一种特殊结构的网络——卷积神经网络 (Convolutional Neural Network, CNN)——来识别手写的邮政编码 (LeCun et al., 1989)。卷积网络的灵感部分来自福岛邦彦 (Kunihiko Fukushima) 1980 年提出的新认知机 (Neocognitron) (Fukushima, 1980),而后者又受到休伯尔 (Hubel) 和威泽尔 (Wiesel) 对猫视觉皮层研究的启发。LeCun 的系统后来被用于银行支票识别,在 20 世纪 90 年代末处理了美国相当比例的支票,是神经网络最早的大规模商业应用之一。
尽管有这些进展,神经网络在 20 世纪 90 年代初依然面临困境:网络一深就难以训练,训练数据和算力都很有限,而接下来将要登场的统计学习方法——尤其是支持向量机——在许多任务上表现更好,理论也更优雅。神经网络将再次进入一段相对沉寂的时期。
本章小结
-
专家系统用“若…则…”规则编码领域知识,通过推理引擎(正向/反向链接)得出可解释的结论;DENDRAL、MYCIN、XCON 是代表。
-
专家系统带来了 AI 第一次商业繁荣,但受困于知识获取瓶颈、脆弱性、维护困难和无法学习,加上 Lisp 机市场崩溃,导致了第二次寒冬(约 1987—1993)。
-
符号主义与联结主义是 AI 的两大流派;神经符号 AI 试图结合二者的优点。
-
Hopfield 网络(1982)和玻尔兹曼机把统计物理思想引入神经网络,两位开创者获得了 2024 年诺贝尔物理学奖。
-
反向传播(1986 年广为人知)解决了多层网络的训练问题,并揭示了隐藏层可以自动学习表示。
-
万能近似定理保证了神经网络的表达能力;LeCun 的卷积网络实现了早期的商业成功。
习题
-
(编程) 为本章的正向链接程序增加一条规则“R4:如果 疑似肺炎 且 对青霉素过敏,那么 避免使用青霉素”,并给出一组事实使 R4 被触发。
-
(编程) 修改
forward_chain,让它在推理结束后能够回答“为什么得出某结论”,即输出从初始事实到该结论的完整推理链。 -
(概念) 列举专家系统的三个主要缺陷,并分别说明现代大语言模型是缓解了还是加剧了这些问题。
-
(概念) 什么是“信用分配问题”?反向传播是如何解决它的?
-
(概念) 万能近似定理说明单隐藏层网络能逼近任意连续函数。既然如此,为什么我们还需要“深度”网络?(提示:考虑所需神经元的数量,可以先给出你的猜想,卷五会深入讨论。)
延伸阅读
-
Rumelhart, D. E., Hinton, G. E., & Williams, R. J. (1986). Learning Representations by Back-propagating Errors. Nature, 323, 533–536. ——只有四页,强烈推荐阅读。
-
Shortliffe, E. H. (1976). Computer-Based Medical Consultations: MYCIN. Elsevier.
-
Hopfield, J. J. (1982). Neural Networks and Physical Systems with Emergent Collective Computational Abilities. PNAS, 79(8), 2554–2558.
-
LeCun, Y., et al. (1989). Backpropagation Applied to Handwritten Zip Code Recognition. Neural Computation, 1(4), 541–551.