深度学习革命:2006—2017
2012 年秋天,一个名为 AlexNet 的卷积神经网络在 ImageNet 图像识别竞赛中以碾压性的优势夺冠,错误率比第二名低了十多个百分点。这一结果像一颗炸弹,在几年之内彻底改变了计算机视觉、语音识别和自然语言处理的研究格局。神经网络换上了一个新名字——深度学习 (Deep Learning)——重新回到了 AI 舞台的中央。本章讲述这场革命的来龙去脉,以及它为什么偏偏在这个时候发生。
革命的三个要素
深度学习背后的核心思想——多层神经网络和反向传播——在 1986 年就已经成熟了。为什么要等到 2012 年才爆发?答案是三个要素在这一时期同时到位:
-
数据:互联网和智能手机带来了海量的图片、文本和语音数据。2009 年发布的 ImageNet 数据集包含超过一千万张人工标注的图片。
-
算力:图形处理器 (Graphics Processing Unit, GPU) 原本为游戏设计,却恰好擅长神经网络所需的大规模并行矩阵运算。2007 年英伟达推出 CUDA 编程平台后,研究者可以方便地用 GPU 进行通用计算。2009 年,斯坦福的研究表明,用 GPU 训练大型神经网络可以比 CPU 快数十倍 (Raina, Madhavan & Ng, 2009)。
-
算法改进:一系列“小技巧”解决了深层网络难以训练的问题,如 ReLU 激活函数、Dropout 正则化、更好的权重初始化方法、批归一化等。
思考
这三个要素中,你认为哪一个最关键?请注意:大语言模型的兴起同样依赖这三个要素——互联网规模的文本数据、数以万计的 GPU 集群,以及 Transformer 架构。理解这种“三要素共振”,有助于你预判下一次技术突破可能来自哪里。
序幕:深度信念网络
2006 年,辛顿与合作者发表了《深度信念网络的快速学习算法》(Hinton, Osindero & Teh, 2006)。他们提出用逐层无监督预训练的方式初始化深层网络:先用受限玻尔兹曼机一层一层地学习数据的特征,再用反向传播对整个网络进行微调。这一方法第一次让人们相信“深层网络是可以训练的”,并且正是在这一时期,“深度学习”这个说法开始流行起来。
有趣的是,逐层预训练后来被证明并非必要——有了 ReLU、合理的初始化和足够的数据,直接端到端地训练深层网络效果更好。但“先在大量无标签数据上预训练,再在具体任务上微调”的思想,在十多年后以完全不同的形式成为大语言模型的核心范式。
ImageNet 与 AlexNet
ImageNet:为 AI 建一座图书馆
2006 年前后,普林斯顿大学(后转至斯坦福大学)的李飞飞 (Fei-Fei Li) 开始了一个当时被许多人认为“不值得”的项目:构建一个规模空前的图像数据集。她的团队借助亚马逊众包平台 Mechanical Turk,组织了数万名标注者,按照 WordNet 词汇层级对图片进行分类。2009 年发布的 ImageNet 最终包含超过 1400 万张图片、两万多个类别 (Deng et al., 2009)。
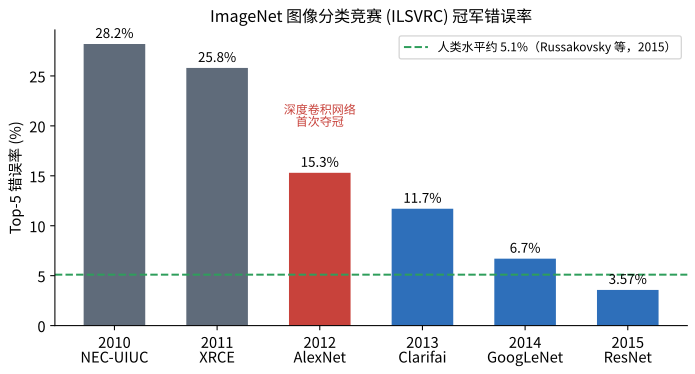
从 2010 年起,基于 ImageNet 的子集(约 128 万张训练图片、1000 个类别)举办的 ImageNet 大规模视觉识别挑战赛 (ILSVRC) 成为计算机视觉领域最重要的年度竞赛 (Russakovsky et al., 2015)。主要评测指标是 Top-5 错误率:模型给出的 5 个最可能的类别中都不包含正确答案的比例。
2012:AlexNet 横空出世
前两届比赛的冠军都使用传统方法:人工设计的图像特征(如 SIFT)加上 SVM 等分类器,Top-5 错误率分别约为 28% 和 26%。2012 年,多伦多大学辛顿的学生亚历克斯·克里热夫斯基 (Alex Krizhevsky) 和伊利亚·苏茨克维 (Ilya Sutskever) 提交了一个 8 层的卷积神经网络,后称 AlexNet,将 Top-5 错误率降到了 15.3%,而第二名约为 26.2% (Krizhevsky, Sutskever & Hinton, 2012)。
AlexNet 的成功来自几项关键设计:
-
规模:约 6000 万个参数、65 万个神经元,比 LeNet-5 大了上千倍;
-
GPU 训练:在两块 NVIDIA GTX 580 显卡(每块 3GB 显存)上训练了五到六天,模型被拆分到两块 GPU 上——这可以看作模型并行的早期实践;
-
ReLU 激活函数:\(\text{ReLU}(z) = \max(0,z)\),比 Sigmoid 训练快得多,且缓解了梯度消失;
-
Dropout:训练时随机“关闭”一部分神经元,防止过拟合;
-
数据增强:对训练图片进行随机裁剪、翻转和颜色扰动,扩充数据。
此后的进展如 图 6.1 所示:2014 年谷歌的 GoogLeNet 和牛津大学的 VGG 网络把网络深度推到了 20 层左右;2015 年,微软亚洲研究院何恺明 (Kaiming He) 等人提出的 残差网络 (ResNet) 达到了 152 层,Top-5 错误率降至 3.57%,低于研究者对人类表现约 5.1% 的估计 (He et al., 2016)。
历史小故事 一场改变命运的拍卖
AlexNet 论文发表后不久,辛顿和他的两名学生成立了一家只有三个人的公司 DNNresearch。2012 年底,几家科技巨头为收购这家公司展开了竞价,最终谷歌胜出。这次收购标志着工业界正式全面押注深度学习。苏茨克维后来成为 OpenAI 的联合创始人和首席科学家,深度参与了 GPT 系列模型的研发。
残差连接:让网络更深
为什么深层网络难以训练?何恺明等人观察到一个奇怪的现象:在一定深度之后,继续加深网络反而会使训练误差上升。这不是过拟合,而是优化本身变得困难。ResNet 的解决方案极为简洁:让每一组层学习的不是目标映射 \(H\left( \mathbf{x} \right)\) 本身,而是残差 \(F\left( \mathbf{x} \right) = H\left( \mathbf{x} \right) - \mathbf{x}\),输出为
这条“捷径”(Shortcut) 使得梯度可以直接从深层流向浅层,即使网络有上百层也能有效训练。残差连接 (Residual Connection) 是深度学习中最重要的结构发明之一——今天每一个 Transformer 层中都有两条残差连接。
语音、词向量与序列模型
语音识别的突破
图像领域之外,深度学习几乎同时在语音识别中取得了突破。2012 年,来自多伦多大学、微软、谷歌和 IBM 的研究者联合发表综述,报告用深度神经网络替代高斯混合模型后,多个语音识别基准上的错误率显著下降 (Hinton et al., 2012)。几年之内,主流语音助手都换成了基于深度学习的识别引擎。
词向量:意义的几何
如何让神经网络处理文字?最简单的做法是给每个词分配一个编号,再表示为 独热向量 (One-hot Vector)——除了对应位置为 1,其余全为 0。但这种表示无法体现词与词之间的相似性:“猫”和“狗”的距离与“猫”和“汽车”的距离一样远。
2013 年,谷歌的托马斯·米科洛夫 (Tomas Mikolov) 等人提出了 word2vec (Mikolov et al., 2013),用一个浅层神经网络在大规模语料上学习每个词的稠密向量表示,即 词嵌入 (Word Embedding)。其训练目标很简单:根据上下文预测中心词,或根据中心词预测上下文。依据的是语言学中的分布假设:“一个词的意义由它的上下文决定。”
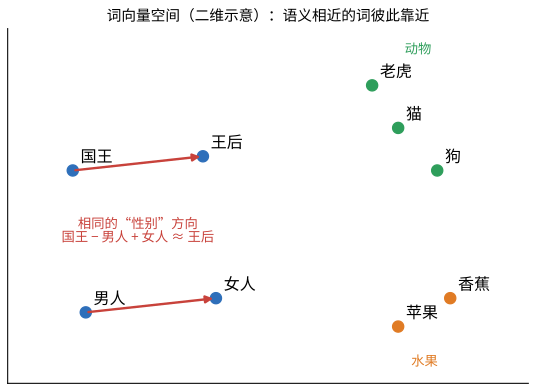
令人惊讶的是,学到的词向量空间呈现出有意义的几何结构(图 6.2):语义相近的词彼此靠近;而且某些关系可以用向量运算表达,最著名的例子是 \(\mathbf{v}(\text{国王}) - \mathbf{v}(\text{男人}) + \mathbf{v}(\text{女人}) \approx \mathbf{v}(\text{王后})\)。词嵌入是今天大语言模型的第一层——每个输入词元首先被映射为一个高维向量(在大模型中通常有数千维)。
序列到序列与注意力
2014 年,苏茨克维等人提出了 序列到序列 (Sequence to Sequence, Seq2Seq) 模型 (Sutskever, Vinyals & Le, 2014):用一个 LSTM 编码器 (Encoder) 把输入句子压缩成一个固定长度的向量,再用另一个 LSTM 解码器 (Decoder) 逐词生成输出句子。这个框架可以端到端地学习机器翻译,不再需要统计机器翻译中复杂的流水线。
但把整个句子压缩成一个固定长度的向量是一个瓶颈:句子越长,信息损失越严重。同年,巴赫达瑙 (Dzmitry Bahdanau)、赵京贤 (Kyunghyun Cho) 和本吉奥提出了 注意力机制 (Attention Mechanism) (Bahdanau, Cho & Bengio, 2015):解码器在生成每个词时,可以“回头看”编码器所有位置的隐状态,并根据相关程度对它们加权求和。翻译“猫”这个词时,模型会把注意力集中在原文的“cat”上。注意力机制大幅提升了长句翻译的质量,2016 年谷歌把神经机器翻译部署到了谷歌翻译中。三年后,一篇论文将提出一个大胆的想法:也许我们只需要注意力。
生成模型与深度强化学习
生成对抗网络
2014 年,伊恩·古德费洛 (Ian Goodfellow) 等人提出了 生成对抗网络 (Generative Adversarial Network, GAN) (Goodfellow et al., 2014)。GAN 由两个网络组成:生成器试图生成以假乱真的图片,判别器试图区分真实图片和生成图片。二者在对抗中共同进步,最终生成器能生成逼真的图像。GAN 开启了深度生成模型的热潮,虽然在图像生成领域后来被扩散模型 (Diffusion Model) 超越,但“生成式 AI”的序幕由此拉开。
DQN 与 AlphaGo
2013 年至 2015 年,伦敦的 DeepMind 公司将深度学习与强化学习结合,提出了 深度 Q 网络 (Deep Q-Network, DQN)。DQN 只以屏幕像素和游戏得分作为输入,就学会了玩数十款雅达利游戏,在其中许多款上达到或超过人类专业测试员的水平 (Mnih et al., 2015)。
2016 年 3 月,DeepMind 的 AlphaGo 在首尔以 4:1 击败围棋世界冠军李世石 (Silver et al., 2016)。围棋曾被认为是 AI 难以攻克的堡垒:搜索空间过于庞大,局面好坏也难以用规则评估。AlphaGo 的解决方案结合了三个要素:
-
策略网络:一个深度卷积网络,先通过学习人类高手棋谱(监督学习)来预测下一步走法,再通过自我对弈的强化学习进一步提升;
-
价值网络:评估当前局面的胜率,替代人工设计的评估函数;
-
蒙特卡洛树搜索 (MCTS):利用两个网络引导搜索,聚焦于最有希望的走法。
2017 年,AlphaGo Zero 更进一步:完全不使用人类棋谱,从随机走子开始仅靠自我对弈学习,几天之内就超越了击败李世石的版本 (Silver et al., 2017)。AlphaGo 系列展示了“深度学习 + 强化学习 + 搜索”的威力,其思想深刻影响了后来用强化学习训练大语言模型进行推理的工作(第 7 章及卷九)。
历史小故事 第 37 手
在与李世石的第二局中,AlphaGo 下出了令所有职业棋手大跌眼镜的第 37 手——一步在人类棋理看来几乎不可能的“肩冲”。解说员一度以为是操作失误。事后看来,这步棋是整盘棋的关键。这一刻常被视为机器第一次展现出“创造性”:它找到了人类数千年都没有发现的下法。而在第四局,李世石也下出了被称为“神之一手”的第 78 手,赢下了人类在这场比赛中唯一的一局。
深度学习的工具链
这一时期,深度学习的软件生态也迅速成熟,让研究者不必再手写反向传播:
-
Theano(2007 年起,蒙特利尔大学):最早支持自动微分和 GPU 计算的框架之一;
-
Caffe(2013 年,伯克利):在计算机视觉领域广泛使用;
-
TensorFlow(2015 年,谷歌):基于静态计算图,适合大规模部署;
-
PyTorch(2017 年初公开发布,Facebook,即今天的 Meta):基于动态计算图,像写普通 Python 代码一样灵活,迅速成为学术界的首选,今天也是大模型训练的主流框架。本系列从卷五开始将全面使用 PyTorch。
同时,优化算法也在进步。Adam 优化器 (Kingma & Ba, 2015) 结合了动量和自适应学习率,成为训练神经网络的默认选择;它的变体 AdamW 至今仍是训练大语言模型的标准优化器。
表 6.1 深度学习革命大事记(年份以论文正式发表或事件发生为准)
| 年份 | 成果 | 意义 |
|---|---|---|
| 2006 | 深度信念网络 | 证明深层网络可以训练,“深度学习”一词流行 |
| 2009 | ImageNet | 大规模标注数据集,催生 ILSVRC 竞赛 |
| 2012 | AlexNet | GPU 训练的深度 CNN 在 ImageNet 上大胜,引爆深度学习 |
| 2013 | word2vec | 稠密词向量,语义的几何表示 |
| 2014 | Seq2Seq、GAN、Adam | 端到端序列生成;对抗式生成模型;标准优化器 |
| 2015 | 注意力机制、ResNet、DQN | 软对齐;残差连接让网络达到上百层;深度强化学习 |
| 2016 | AlphaGo | 击败围棋世界冠军 |
| 2017 | AlphaGo Zero、Transformer | 纯自我对弈;“注意力就是一切”(第 7 章) |
本章小结
-
深度学习在 2012 年前后爆发,源于三个要素的共振:大数据(ImageNet)、大算力(GPU + CUDA)和算法改进(ReLU、Dropout、更好的初始化等)。
-
AlexNet 在 2012 年 ImageNet 竞赛中大幅领先,ResNet 在 2015 年以残差连接训练出 152 层网络,错误率低于人类估计值。
-
词向量用稠密向量表示词义,语义关系体现为几何关系;Seq2Seq 实现了端到端翻译,注意力机制解决了固定长度向量的瓶颈。
-
GAN 开启了深度生成模型;DQN 和 AlphaGo 展示了深度强化学习的威力,AlphaGo Zero 仅靠自我对弈就超越了人类知识。
-
Theano、TensorFlow、PyTorch 等框架和 Adam 优化器让深度学习工程化;PyTorch 是今天大模型训练的主流框架。
习题
-
(概念) 为什么说 GPU 特别适合训练神经网络?请从“神经网络的主要计算是什么”的角度回答。
-
(计算) 一个全连接层把 4096 维输入映射到 4096 维输出(含偏置),它有多少个参数?若用 32 位浮点数存储,需要多少 MB?(1 MB 按 \(2^{20}\) 字节计算。)
-
(概念) 残差连接 \(\mathbf{y} = F\left( \mathbf{x} \right) + \mathbf{x}\) 为什么有助于训练很深的网络?考虑 \(F\) 的所有权重都接近 0 的情形。
-
(编程) 用 NumPy 实现余弦相似度函数
cos_sim(a, b),并构造三个三维向量表示“猫”“狗”“汽车”,使“猫”与“狗”的相似度高于“猫”与“汽车”。 -
(概念) Seq2Seq 模型把整个输入句子压缩成一个固定长度向量会带来什么问题?注意力机制是如何解决的?
-
(思考) AlphaGo Zero 不使用任何人类棋谱就超越了人类。这对于“大语言模型能否超越训练数据中的人类水平”这一问题有什么启示?两者有什么关键区别?
延伸阅读
-
Krizhevsky, A., Sutskever, I., & Hinton, G. E. (2012). ImageNet Classification with Deep Convolutional Neural Networks. NeurIPS.
-
He, K., Zhang, X., Ren, S., & Sun, J. (2016). Deep Residual Learning for Image Recognition. CVPR.
-
Mikolov, T., Chen, K., Corrado, G., & Dean, J. (2013). Efficient Estimation of Word Representations in Vector Space. arXiv:1301.3781.
-
Bahdanau, D., Cho, K., & Bengio, Y. (2015). Neural Machine Translation by Jointly Learning to Align and Translate. ICLR.
-
Silver, D., et al. (2016). Mastering the Game of Go with Deep Neural Networks and Tree Search. Nature, 529, 484–489.
-
Goodfellow, I., Bengio, Y., & Courville, A. (2016). Deep Learning. MIT Press. ——深度学习领域的经典教材。