什么是人工智能
“人工智能”这个词每天都出现在新闻里,但如果你追问十个人“它到底是什么”,很可能会得到十个不同的答案。有人认为能下棋的程序就是 AI,有人认为只有像人一样有意识的机器才算 AI,还有人干脆说“AI 就是还没实现的那些东西”。本章先为这个模糊的概念建立一个清晰的框架。
定义人工智能的四种视角
1956 年,约翰·麦卡锡 (John McCarthy) 在筹备达特茅斯会议时首次使用了 人工智能 (Artificial Intelligence) 一词。他后来给出的定义相当朴素:“制造智能机器的科学与工程。”问题在于,“智能”本身就难以定义。
经典教材《人工智能:一种现代方法》(Russell & Norvig, 2020) 把历史上各种定义归纳为一个 \(2 \times 2\) 的框架:一个维度是关注思维过程还是关注外在行为;另一个维度是以人类表现为标准还是以理性(rationality,即在给定信息下做出最优决策)为标准。
表 1.1 定义人工智能的四种视角(根据 Russell & Norvig 的框架整理)
| 以人类为标准 | 以理性为标准 | |
|---|---|---|
| 思维 | 像人一样思考:认知建模,研究人脑如何工作并用程序模拟(认知科学路线) | 理性地思考:用形式逻辑进行正确推理(“思维法则”路线) |
| 行为 | 像人一样行动:让机器的行为与人无法区分(图灵测试路线) | 理性地行动:构建能最大化期望效用的理性智能体(现代主流路线) |
现代 AI 研究的主流采用右下角的视角:AI 是关于构建理性智能体的学问。这个视角的好处是可以量化、可以工程化——我们不需要回答“机器有没有意识”这样的哲学难题,只需要问“它在给定任务上做得有多好”。今天训练大语言模型时,我们实际上也是在优化一个可度量的目标(预测下一个词元的准确程度),而不是直接追求“像人一样思考”。
图灵测试与中文屋
模仿游戏
1950 年,英国数学家艾伦·图灵 (Alan Turing) 在哲学期刊 Mind 上发表了《计算机器与智能》(Computing Machinery and Intelligence)。论文开篇提出“机器能思考吗?”这个问题,但图灵认为它太含糊,于是用一个可操作的游戏代替它——模仿游戏 (Imitation Game),后人称之为 图灵测试 (Turing Test)。
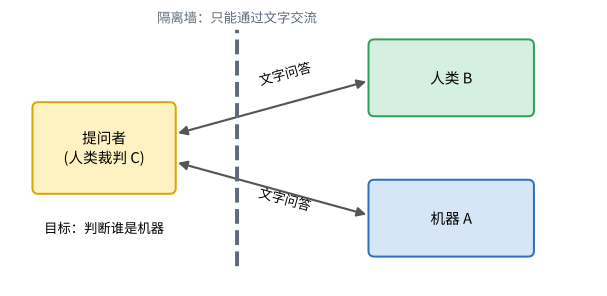
如 图 1.1 所示,一名人类裁判通过文字终端与两个看不见的对象对话,其中一个是人,一个是机器。如果裁判无法可靠地区分二者,我们就有理由说这台机器表现出了智能。图灵在论文中预言,大约五十年后(即 2000 年前后),计算机将能在五分钟的对话后让普通裁判做出正确判断的概率不超过 70%。
图灵测试的深刻之处在于它把“智能”转化为行为上的可检验标准。论文中图灵还逐一反驳了九种反对意见(例如“机器只能做我们让它做的事”),并在最后一节“学习机器”(Learning Machines) 中提出:与其直接编写一个成人的心智,不如编写一个“儿童的心智”,然后让它通过学习成长。这一洞见比机器学习成为主流早了半个多世纪。
中文屋论证
1980 年,哲学家约翰·塞尔 (John Searle) 提出了著名的 中文屋 (Chinese Room) 思想实验 (Searle, 1980)。设想一个完全不懂中文的人被关在房间里,手里有一本详尽的规则手册:看到什么样的中文字符输入,就按规则输出什么样的中文字符。屋外的人递进中文问题,收到流利的中文回答,会以为屋里的人懂中文——但屋里的人其实对意义一无所知。
塞尔据此认为:仅仅操纵符号(语法)并不足以产生理解(语义),因此通过图灵测试并不意味着真正的智能。这场争论至今没有定论。面对今天能写诗、能编程的大语言模型,“它真的理解吗?”依然是一个开放的问题。作为工程师,我们可以暂时搁置这个哲学问题,但要记住:行为上的出色不等于机制上的可靠,这也是为什么大模型会自信地“一本正经地胡说八道”(即幻觉,Hallucination)。
思考
今天的大语言模型在很多日常对话中已经很难被区分于人类。你认为它们通过图灵测试了吗?如果通过了,这说明图灵测试是一个好的智能标准,还是说明它有缺陷?
智能体视角
现代 AI 最常用的统一框架是 智能体 (Agent)。智能体是任何能够通过传感器感知环境、并通过执行器作用于环境的系统。
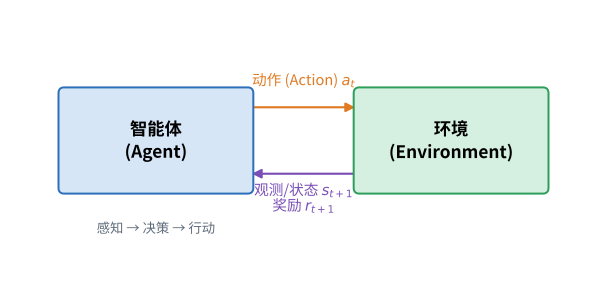
图 1.2 描述了这个循环:在时刻 \(t\),智能体观察到环境状态 \(s_{t}\),选择动作 \(a_{t}\);环境随之转移到新状态 \(s_{t + 1}\),并可能给出一个奖励 \(r_{t + 1}\)。理性智能体 (Rational Agent) 就是在每一步都选择能使期望累积表现最大化的动作的智能体。
这个框架非常通用:
-
扫地机器人:传感器是摄像头和碰撞传感器,执行器是轮子和刷子,表现度量是清扫面积与耗电量。
-
国际象棋程序:环境是棋盘,动作是走子,表现度量是胜率。
-
大语言模型聊天助手:环境是对话上下文,动作是生成的下一个词元,表现度量(在对齐阶段)是人类偏好或任务成功率。
-
编程智能体(Coding Agent):环境是代码仓库和终端,动作是读文件、写代码、运行测试。
智能体视角也是强化学习 (Reinforcement Learning) 的基础语言,我们将在第 8 章和卷九(后训练与对齐)中反复用到它。
AI、机器学习、深度学习与大模型
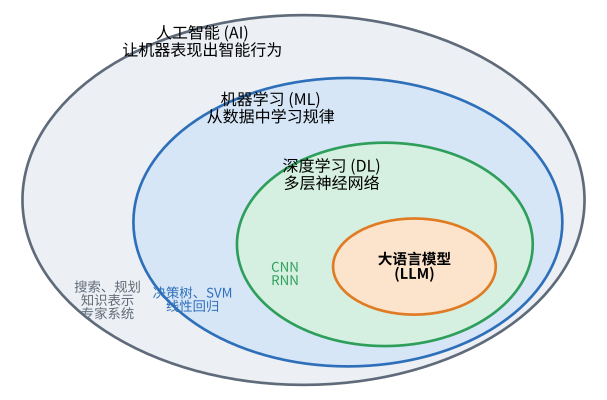
日常讨论中,这几个词经常被混用。它们的关系其实是层层包含的,如 图 1.3 所示。
-
人工智能 (AI) 是最大的范畴,包括一切让机器表现出智能行为的方法:搜索与规划、逻辑推理、知识表示、专家系统,以及机器学习。
-
机器学习 (Machine Learning, ML) 是 AI 的一个子领域,其特点是不直接编写规则,而是让程序从数据中学习规律。这个术语由 IBM 的亚瑟·塞缪尔 (Arthur Samuel) 在 1959 年研究跳棋程序时推广开来 (Samuel, 1959)。
-
深度学习 (Deep Learning, DL) 是机器学习的一个分支,使用由多层人工神经网络 (Artificial Neural Network) 构成的模型,能够自动从原始数据中学习层次化的表示。
-
大语言模型 (Large Language Model, LLM) 是深度学习在语言上的一个应用:基于 Transformer 架构、在海量文本上训练、参数量通常达到数十亿乃至数千亿的模型。
例题 区分不同的方法
判断下列系统分别属于 AI 的哪一层(可能同时属于多层,请给出最内层): (a) 1997 年击败卡斯帕罗夫的“深蓝”;(b) 垃圾邮件过滤器使用的朴素贝叶斯分类器;(c) 手机相册中的人脸识别;(d) ChatGPT。
解答:(a) 深蓝的核心是搜索(每秒评估约两亿个局面)加上人工设计的评估函数,它属于 AI 但基本不属于机器学习;(b) 朴素贝叶斯从带标签的邮件中统计词频,属于机器学习,但不是深度学习;(c) 现代人脸识别使用卷积神经网络,属于深度学习;(d) ChatGPT 基于 GPT 系列 Transformer,属于大语言模型。
弱人工智能、强人工智能与 AGI
另一个常见的分类是按照能力的广度:
-
狭义人工智能 (Narrow AI),也称弱人工智能:只能在特定任务上表现出智能,如下围棋的 AlphaGo、识别人脸的系统。直到 2010 年代末,几乎所有实用 AI 都属于此类。
-
通用人工智能 (Artificial General Intelligence, AGI):能像人一样在广泛的任务上学习和解决问题,并能把一个领域的知识迁移到新领域。
-
强人工智能 (Strong AI):这个词源于塞尔,指“真正拥有心智和理解”的机器,更偏哲学含义。
大语言模型的出现模糊了狭义和通用的边界:同一个模型可以翻译、写代码、解数学题、做摘要。是否已经出现“AGI 的雏形”,是当前学术界和产业界争论最激烈的话题之一。本系列不试图回答这个问题,而是让你掌握亲手构建这些系统的能力,从而形成自己的判断。
莫拉维克悖论
20 世纪 80 年代,机器人学家汉斯·莫拉维克 (Hans Moravec) 等人注意到一个反直觉的现象:对人类来说困难的事情(如下棋、做微积分),对计算机来说相对容易;而对人类来说毫不费力的事情(如走路、识别人脸、叠衣服),对计算机来说却极其困难。这被称为 莫拉维克悖论 (Moravec’s Paradox) (Moravec, 1988)。
一种解释是:感知与运动技能经过了数亿年的进化优化,已经深深“编码”在我们的神经系统中,以至于我们意识不到它们的复杂;而抽象推理是进化上很晚才出现的能力,相对“浅薄”。这个悖论解释了为什么早期 AI 在定理证明上进展神速,却在视觉和机器人上屡屡受挫;也解释了为什么深度学习——一种从海量感知数据中学习的方法——会首先在图像和语音领域取得突破。有趣的是,大模型时代某种程度上又“翻转”了这个悖论:语言和编程能力进展飞快,而灵巧的机器人操作依然是公认的难题。
AI 能做什么:一张能力地图
为了让你对 AI 的应用范围有个直观感受,下表列出了几个主要领域及其代表性任务。后续各卷的内容将覆盖其中与大模型最相关的部分。
| 领域 | 代表性任务 | 核心技术(当前主流) |
|---|---|---|
| 计算机视觉 | 图像分类、目标检测、分割、图像生成 | CNN、视觉 Transformer、扩散模型 |
| 自然语言处理 | 翻译、问答、摘要、对话、代码生成 | Transformer 大语言模型 |
| 语音 | 语音识别、语音合成、实时语音对话 | Transformer、端到端模型 |
| 决策与控制 | 游戏、机器人、自动驾驶、推荐系统 | 强化学习、模仿学习 |
| 科学计算 | 蛋白质结构预测、材料与药物发现、气象预报 | 图神经网络、Transformer |
| 多模态 | 看图说话、视频理解、图文生成 | 多模态大模型 |
本章小结
-
人工智能可以从“思维/行为”与“人类/理性”两个维度来定义;现代主流把 AI 看作构建理性智能体的学问。
-
图灵测试用行为标准替代“机器能否思考”的哲学问题;塞尔的中文屋论证则质疑行为能否等同于理解。
-
智能体框架(感知—决策—行动—奖励)是统一描述各类 AI 系统的语言,也是强化学习的基础。
-
AI ⊃ 机器学习 ⊃ 深度学习 ⊃ 大语言模型:机器学习从数据中学习规律;深度学习使用多层神经网络;大语言模型是在海量文本上训练的超大规模 Transformer。
-
莫拉维克悖论提醒我们:对人容易的事情对机器未必容易,反之亦然。
习题
-
(概念) 用 Russell & Norvig 的四种视角分别举一个 AI 系统的例子,并说明它更符合哪种视角。
-
(概念) 图灵在 1950 年的论文中提出了“学习机器”的设想。请用一两句话说明这个设想与今天的机器学习有何联系。
-
(概念) 为一个“自动驾驶出租车”智能体描述它的环境、传感器、执行器和表现度量。
-
(判断) 判断正误并说明理由:“所有机器学习方法都是深度学习方法。”
-
(思考) 举出一个你身边能体现莫拉维克悖论的例子。
-
(思考) 塞尔的中文屋论证对“大语言模型是否理解语言”这一问题有什么启示?请给出支持和反对两方面的观点。
延伸阅读
-
Turing, A. M. (1950). Computing Machinery and Intelligence. Mind, 59(236), 433–460. ——强烈建议阅读原文,文笔清晰,至今仍有启发。
-
Russell, S., & Norvig, P. (2020). Artificial Intelligence: A Modern Approach (4th ed.). Pearson. 第 1–2 章。
-
Searle, J. R. (1980). Minds, Brains, and Programs. Behavioral and Brain Sciences, 3(3), 417–424.