黄金年代与第一次寒冬:1956—1980
达特茅斯会议之后的近二十年,是 AI 的第一个“黄金年代”。计算机第一次证明了几何定理、解出了代数应用题、用英语与人对话、在积木世界里执行指令。研究者们乐观得近乎狂热:1958 年,西蒙和纽厄尔预言“十年之内,数字计算机将成为国际象棋世界冠军”;1970 年,明斯基在接受《生活》杂志采访时说“三到八年之内,我们将拥有具有普通人智能的机器”。这些预言无一兑现,而过高的期望最终换来了第一次 AI 寒冬 (AI Winter)。
本章有两条主线:一条是以搜索和符号推理为核心的符号主义,它是这一时期的绝对主流;另一条是以感知机为代表的早期联结主义,它从辉煌走向沉寂。
搜索:AI 的第一个通用方法
状态空间
许多智能问题可以抽象为在状态空间中寻找一条从初始状态到目标状态的路径。一个 搜索问题 (Search Problem) 由以下要素定义:
-
状态 (State):问题的一个“快照”,如棋盘上棋子的位置、魔方的当前配置;
-
初始状态 和 目标测试:从哪里出发,如何判断已经到达目标;
-
动作 (Action) 与 转移模型:在每个状态下可以做什么,做完之后到达哪个新状态;
-
路径代价:每一步的成本,例如地图导航中的道路长度。
程序员对此一定不陌生:广度优先搜索 (BFS)、深度优先搜索 (DFS) 就是最基本的无信息搜索 (Uninformed Search)。问题在于,真实问题的状态空间往往大得惊人——国际象棋的合法局面数估计在 \(10^{43}\) 量级,围棋则超过 \(10^{170}\),远超可观测宇宙中的原子数(约 \(10^{80}\))。这种组合爆炸 (Combinatorial Explosion) 是符号 AI 面临的根本挑战。
启发式搜索与 A*
应对组合爆炸的办法是启发式 (Heuristic):用一个估计函数 \(h(n)\) 来评估从状态 \(n\) 到目标还有多远,优先扩展看起来最有希望的节点。1968 年,斯坦福研究院的哈特 (Peter Hart)、尼尔森 (Nils Nilsson) 和拉斐尔 (Bertram Raphael) 为机器人 Shakey 的路径规划提出了 A* 算法 (Hart et al., 1968),它按照
的值来选择下一个扩展的节点,其中 \(g(n)\) 是从起点到 \(n\) 的实际代价,\(h(n)\) 是到目标的估计代价。只要 \(h(n)\) 从不高估真实代价(称为可采纳的启发函数),A* 就保证找到最优路径。半个多世纪后,A* 依然是游戏寻路和机器人导航的标准算法。
博弈树与极小化极大
下棋是早期 AI 最钟爱的试验场,因为它规则清晰、胜负明确,又被公认需要“智能”。双人零和博弈的经典算法是 极小化极大 (Minimax):我方在轮到自己时选择使局面评估值最大的走法,并假设对手总会选择使评估值最小的走法。
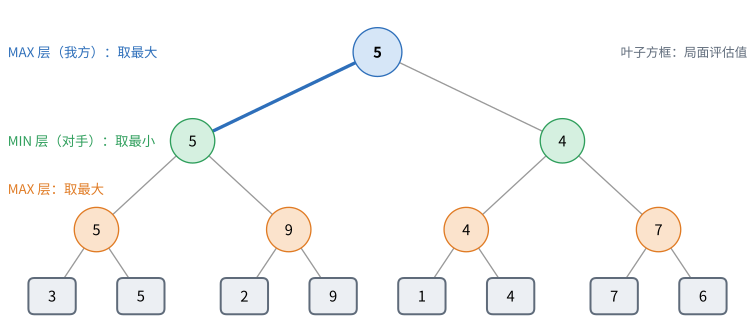
例题 极小化极大的计算
在 图 3.1 中,搜索深度为三层。从叶子开始自底向上计算:
-
最底层的 MAX 节点取子节点最大值:\(\max(3,5) = 5\),\(\max(2,9) = 9\),\(\max(1,4) = 4\),\(\max(7,6) = 7\)。
-
MIN 层取子节点最小值:\(\min(5,9) = 5\),\(\min(4,7) = 4\)。
-
根节点(MAX)取 \(\max(5,4) = 5\),因此我方应选择左边的走法,即使右子树中存在更大的叶子值 7——因为理性的对手不会给我们那样的机会。
实际系统还会使用 α-β 剪枝 (Alpha-Beta Pruning) 跳过不可能影响结果的分支,在最好情况下可以把可搜索深度提高约一倍。
1959 年,塞缪尔的跳棋程序就已经结合了博弈树搜索和自我对弈学习:程序通过与自己的副本下棋来调整评估函数中各特征的权重,最终达到了业余高手水平 (Samuel, 1959)。这是“机器学习”一词最早的代表性工作,也是五十多年后 AlphaGo“自我对弈”思想的先驱。
物理符号系统假设
搜索和逻辑推理的成功,让纽厄尔和西蒙提出了一个雄心勃勃的论断——物理符号系统假设 (Physical Symbol System Hypothesis):
“一个物理符号系统具有产生一般智能行为的必要且充分的手段。”(Newell & Simon, 1976)
所谓物理符号系统,就是能够创建、复制、修改和组合符号结构的系统——计算机正是这样的系统。这个假设是符号主义 (Symbolism) 的哲学纲领:智能的本质是符号操作,只要找到正确的符号表示和推理规则,就能实现智能。
为了方便地操作符号,麦卡锡在 1958 年发明了 Lisp 语言。Lisp 的代码本身就是一种数据结构(列表),程序可以方便地生成和修改程序,这一特性使它成为此后三十年 AI 研究的首选语言。Lisp 也率先引入了垃圾回收、条件表达式、递归函数等今天程序员习以为常的概念。
早期的明星系统
| 系统 | 年代 | 做了什么,意味着什么 |
|---|---|---|
| 通用问题求解器 GPS | 1957–1959 | 用“手段—目的分析”求解形式化谜题;体现了通用推理的野心 |
| ELIZA | 1966 | 魏森鲍姆 (Weizenbaum) 的聊天程序,用模式匹配扮演心理治疗师;许多人对它产生了情感依赖 |
| Shakey 机器人 | 1966–1972 | 第一个能感知、规划并行动的移动机器人;催生了 A* 算法和 STRIPS 规划语言 |
| SHRDLU | 1968–1970 | 维诺格拉德 (Winograd) 的积木世界对话系统,能理解“把红色方块放到蓝色金字塔旁边” |
| DENDRAL | 1965 起 | 根据质谱数据推断分子结构,被视为第一个专家系统(见第 4 章) |
历史小故事 ELIZA 效应
ELIZA 的原理极其简单:识别输入中的关键词,然后套用模板回答。比如用户说“我很担心我的母亲”,它就回答“跟我说说你的家庭吧”。然而魏森鲍姆震惊地发现,连他的秘书都会要求他离开房间,好与 ELIZA “私下交谈”——他后来在著作中详细记述了这段经历,并由此对 AI 的社会影响进行了深刻反思 (Weizenbaum, 1976)。人们倾向于把理解和情感投射到会说话的机器上,这一现象被称为 ELIZA 效应。在大语言模型时代,这个效应比以往任何时候都更值得警惕。
这些系统有一个共同特点:它们在精心限定的微世界 (Microworld) 里表现惊艳,但一旦走出微世界就寸步难行。SHRDLU 无法理解积木世界以外的任何事物;GPS 面对真实世界的问题时,状态空间会立刻爆炸。从“玩具问题”扩展到“真实问题”的困难,是第一次寒冬的根源之一。
感知机:会学习的神经元
Rosenblatt 的感知机
就在符号主义高歌猛进的同时,康奈尔航空实验室的心理学家弗兰克·罗森布拉特 (Frank Rosenblatt) 走上了另一条路。1958 年,他提出了 感知机 (Perceptron) (Rosenblatt, 1958)。与 M-P 神经元相比,感知机有两个关键改进:输入和权重可以是实数,并且权重可以从数据中自动学习。
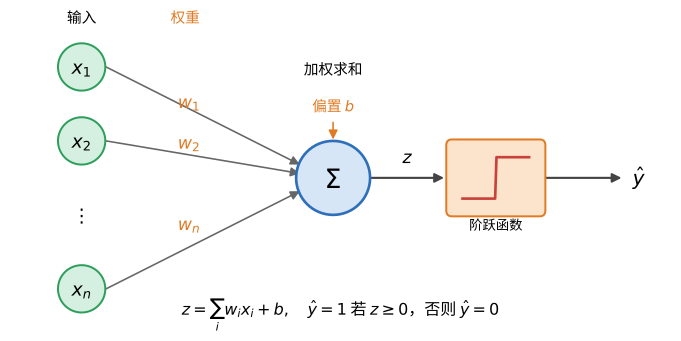
如 图 3.2 所示,感知机计算输入的加权和,再通过阶跃函数输出:
几何上,方程 \(\mathbf{w}^{\top}\mathbf{x} + b = 0\) 定义了输入空间中的一个超平面(二维时就是一条直线),感知机把位于一侧的点判为 1 类,另一侧判为 0 类。因此感知机是一个线性分类器 (Linear Classifier)。
感知机学习规则
感知机的学习规则非常简洁:对每个训练样本 \(\left( \mathbf{x},y \right)\),先计算预测 \(\hat{y}\),然后
其中 \(\eta > 0\) 是学习率 (Learning Rate)。规则的直觉是:预测正确时 \(y - \hat{y} = 0\),不做任何修改;把正例错判为负例时 (\(y = 1,\hat{y} = 0\)),就把 \(\mathbf{x}\) 加到权重上,使得下次 \(\mathbf{w}^{\top}\mathbf{x}\) 更大;反之则减去。
感知机收敛定理 (Perceptron Convergence Theorem) 保证:只要训练数据是线性可分的,感知机学习算法一定会在有限步内找到一个能完美分开数据的超平面。这是机器学习历史上第一个关于学习算法的严格理论保证。
例题 手算感知机学习与门
训练数据为与门的真值表:\((0,0) \rightarrow 0\),\((0,1) \rightarrow 0\),\((1,0) \rightarrow 0\),\((1,1) \rightarrow 1\)。初始化 \(\mathbf{w} = (0,0)\),\(b = 0\),学习率 \(\eta = 1\),约定 \(z \geq 0\) 时输出 1。第一轮 (epoch) 的计算过程如下:
::: {align="center"} | 样本 \(\mathbf{x}\) | \(y\) | \(z = \mathbf{w}^{\top}\mathbf{x} + b\) | \(\hat{y}\) | 是否更新 | 更新后 \(\left( \mathbf{w},b \right)\) | |:--:|:--:|:--:|:--:|:--:|:--:| | (0, 0) | 0 | 0 | 1 | 是,\(y - \hat{y} = - 1\) | (0, 0), −1 | | (0, 1) | 0 | −1 | 0 | 否 | (0, 0), −1 | | (1, 0) | 0 | −1 | 0 | 否 | (0, 0), −1 | | (1, 1) | 1 | −1 | 0 | 是,\(y - \hat{y} = + 1\) | (1, 1), 0 | :::
继续迭代,第 2 至 5 轮分别出现 3、3、2、1 次错误,第 6 轮全部正确,算法收敛到 \(\mathbf{w} = (2,1)\),\(b = - 3\)。验证:只有 \((1,1)\) 满足 \(2 \cdot 1 + 1 \cdot 1 - 3 = 0 \geq 0\),其余三个点的 \(z\) 都小于 0。决策边界为直线 \(2x_{1} + x_{2} = 3\)。
用 Python 实现只需十几行:
import numpy as np

def train_perceptron(X, y, lr=1.0, max_epochs=100):
    w, b = np.zeros(X.shape[1]), 0.0
    for epoch in range(1, max_epochs + 1):
        errors = 0
        for xi, yi in zip(X, y):
            y_hat = int(w @ xi + b >= 0)
            if y_hat != yi:                      # 只在出错时更新
                w += lr * (yi - y_hat) * xi
                b += lr * (yi - y_hat)
                errors += 1
        if errors == 0:
            return w, b, epoch
    return w, b, None                            # 未收敛

X = np.array([[0, 0], [0, 1], [1, 0], [1, 1]], dtype=float)
print(train_perceptron(X, np.array([0, 0, 0, 1])))   # AND: 收敛
print(train_perceptron(X, np.array([0, 1, 1, 1])))   # OR : 收敛
print(train_perceptron(X, np.array([0, 1, 1, 0])))   # XOR: 永不收敛
媒体的狂热
1958 年 7 月,美国海军研究办公室举行发布会展示感知机。《纽约时报》报道说,海军展示了一台电子计算机的雏形,“期望它将能够行走、说话、看见、书写、自我复制并意识到自己的存在”。罗森布拉特随后建造了专用硬件 Mark I 感知机,用 \(20 \times 20\) 的光电管阵列作为“视网膜”,用电动机驱动的电位器作为可调权重,能够学习识别简单的字母图形。这种对新技术的过度渲染,在 AI 历史上将一再上演。
《感知机》与 XOR 问题
1969 年,明斯基和西摩·佩珀特 (Seymour Papert) 出版了《感知机》(Perceptrons) 一书 (Minsky & Papert, 1969)。这本书对感知机的能力做了严谨的数学分析,其中最广为人知的结论是:单层感知机无法表示异或 (XOR) 函数。
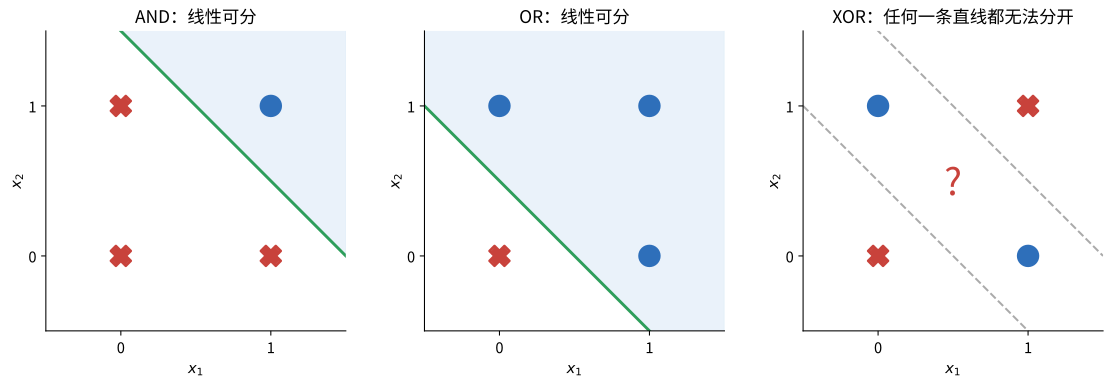
原因一目了然(图 3.3):XOR 的两个正例 \((0,1)\) 和 \((1,0)\) 位于对角线上,两个负例 \((0,0)\) 和 \((1,1)\) 位于另一条对角线上,平面上不存在任何一条直线能把它们分开。我们也可以用代数证明:假设存在 \(w_{1},w_{2},b\) 使感知机实现 XOR,则
-
由 \((0,0) \rightarrow 0\) 得 \(b < 0\);
-
由 \((0,1) \rightarrow 1\) 和 \((1,0) \rightarrow 1\) 得 \(w_{2} + b \geq 0\) 和 \(w_{1} + b \geq 0\);
-
两式相加得 \(w_{1} + w_{2} + 2b \geq 0\),即 \(w_{1} + w_{2} + b \geq - b > 0\);
-
但 \((1,1) \rightarrow 0\) 要求 \(w_{1} + w_{2} + b < 0\),矛盾。
当然,第 2 章已经看到,两层神经元就能实现 XOR。明斯基和佩珀特也清楚多层网络在表示能力上更强,但他们指出,当时没有人知道如何训练多层网络,并且对多层网络的前景表示悲观。这本书加上罗森布拉特在 1971 年的意外去世,使神经网络研究在此后十余年间几乎陷入停滞。真正的解决方案——反向传播算法——要到 20 世纪 80 年代才被广泛接受(第 4 章)。
思考
《感知机》一书经常被描述为“扼杀了神经网络研究”。但书中的数学结论本身是正确的。你认为问题出在结论本身,还是出在人们对结论的过度解读上?这对你今天阅读“某某方法的局限性”类论文有什么启示?
第一次 AI 寒冬
到 20 世纪 70 年代初,AI 的承诺与现实之间的差距已经无法掩盖。主要的技术瓶颈有:
-
算力有限:当时的计算机内存只有几十 KB,运行速度比今天慢百万倍以上。许多方法在原理上可行,却无法在真实规模的问题上运行。
-
组合爆炸:在微世界中有效的搜索方法,一旦面对真实世界的问题,搜索空间就会呈指数增长。
-
常识知识的缺乏:理解一句简单的话往往需要海量背景知识。早期机器翻译的失败是典型例子——1966 年美国的 ALPAC 报告认为机器翻译进展远低于预期,导致相关资助大幅削减。
-
莫拉维克悖论:视觉、运动等“简单”能力远比预期困难。
1973 年,英国数学家詹姆斯·莱特希尔 (James Lighthill) 受英国科学研究委员会委托,发表了一份评估报告(即莱特希尔报告)。报告严厉批评 AI 研究未能实现其“宏伟目标”,认为组合爆炸使大多数方法无法扩展到实际问题 (Lighthill, 1973)。报告发表后,英国几乎停止了对 AI 研究的资助。同一时期,美国国防高级研究计划局 (DARPA) 也因语音理解等项目未达预期而大幅削减了无定向的 AI 研究经费。从 1974 年前后到 1980 年,AI 进入了第一次寒冬。
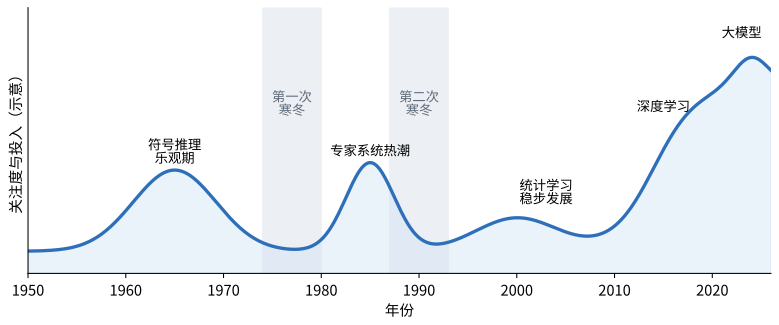
图 3.4 以示意的方式展示了 AI 历史上的几次起伏。每一次寒冬的模式都很相似:一项技术在受限场景中取得成功 → 研究者和媒体做出过度乐观的预测 → 资金和人才涌入 → 技术在真实场景中遇到瓶颈 → 期望破灭、资金撤离。作为未来的 AI 工程师,识别这种模式能帮助你在技术浪潮中保持清醒。
本章小结
-
黄金年代(1956—1974)的主流是符号主义:把智能看作在状态空间中的搜索和对符号的推理。
-
A* 算法和极小化极大搜索是这一时期留下的经典算法,至今仍被广泛使用。
-
物理符号系统假设是符号主义的哲学纲领;Lisp 是符号 AI 的主力语言。
-
感知机(1958)是第一个能从数据中学习的神经网络模型,其学习规则简单,并有收敛定理保证;但它只是线性分类器,无法解决 XOR 这类线性不可分问题。
-
《感知机》(1969)揭示了单层网络的局限,加上算力不足、组合爆炸和常识缺乏,AI 在 1974 年前后进入第一次寒冬。
习题
-
(计算) 对 图 3.1 的博弈树,如果把最右边的叶子 6 改成 10,根节点的值和最佳走法会改变吗?请写出计算过程。
-
(计算) 用感知机学习规则手算 OR 函数的第一轮训练过程(初始化 \(\mathbf{w} = (0,0)\),\(b = 0\),\(\eta = 1\),按 \((0,0),(0,1),(1,0),(1,1)\) 的顺序)。
-
(证明) 仿照本章对 XOR 的证明,证明单层感知机无法实现“同或”(XNOR) 函数,即两个输入相同时输出 1。
-
(编程) 运行本章的
train_perceptron代码,打印每一轮的错误数。对 XOR 数据,权重的变化呈现什么规律? -
(概念) 为什么说 A* 算法中的启发函数 \(h(n)\) 必须“不高估”真实代价才能保证最优性?请举一个高估导致非最优解的直观例子。
-
(思考) 比较第一次 AI 寒冬的成因与今天大模型面临的挑战(如算力成本、幻觉、数据枯竭),有哪些相似之处,又有哪些本质不同?
延伸阅读
-
Rosenblatt, F. (1958). The Perceptron: A Probabilistic Model for Information Storage and Organization in the Brain. Psychological Review, 65(6), 386–408.
-
Minsky, M., & Papert, S. (1969). Perceptrons: An Introduction to Computational Geometry. MIT Press.
-
Hart, P. E., Nilsson, N. J., & Raphael, B. (1968). A Formal Basis for the Heuristic Determination of Minimum Cost Paths. IEEE Transactions on Systems Science and Cybernetics, 4(2), 100–107.
-
Newell, A., & Simon, H. A. (1976). Computer Science as Empirical Inquiry: Symbols and Search. Communications of the ACM, 19(3), 113–126.