统计机器学习时代:1993—2011
走出第二次寒冬的 AI 变得务实而低调。研究者不再奢谈“通用智能”,而是专注于有明确评估标准的具体问题:识别手写数字、过滤垃圾邮件、翻译句子、推荐商品。方法论上也发生了根本转变:从人工编写规则,转向用统计方法从数据中学习。概率论、统计学和优化理论成为 AI 的新数学基础。这一时期,互联网的兴起带来了前所未有的数据量,为后来的深度学习革命埋下了伏笔。
从规则到数据
卡内基梅隆大学的汤姆·米切尔 (Tom Mitchell) 在 1997 年出版的教材《机器学习》中给出了一个被广泛引用的定义 (Mitchell, 1997):
“对于某类任务 \(T\) 和性能度量 \(P\),如果一个计算机程序在 \(T\) 上以 \(P\) 衡量的性能随着经验 \(E\) 而自我完善,那么我们称这个程序从经验 \(E\) 中学习。”
以垃圾邮件过滤为例:任务 \(T\) 是判断一封邮件是否为垃圾邮件;性能 \(P\) 是判断的准确率;经验 \(E\) 是一批已被用户标记过的邮件。与专家系统相比,这种方法有一个巨大的优势:当垃圾邮件的花样翻新时,我们只需要收集新的数据重新训练,而不必让工程师重写规则。
这一转变在许多领域同时发生。语音识别领域,IBM 的弗雷德里克·贾里尼克 (Frederick Jelinek) 领导的团队用统计模型取代了语言学家编写的规则,据说他留下了一句半开玩笑的名言:“每当我解雇一个语言学家,语音识别系统的性能就会提高。”机器翻译领域,IBM 的研究者在 1993 年发表了基于统计模型的翻译方法 (Brown et al., 1993),开启了长达二十年的统计机器翻译时代。2009 年,谷歌的研究者在《数据的不合理有效性》一文中总结道:简单的模型加上海量数据,往往胜过复杂的模型加上少量数据 (Halevy, Norvig & Pereira, 2009)。
支持向量机
20 世纪 90 年代中期到 2010 年前后最受推崇的分类算法,是 支持向量机 (Support Vector Machine, SVM)。它的理论基础来自弗拉基米尔·瓦普尼克 (Vladimir Vapnik) 等人发展的统计学习理论,现代形式由科尔特斯 (Corinna Cortes) 和瓦普尼克于 1995 年提出 (Cortes & Vapnik, 1995)。
最大间隔
回忆感知机:对于线性可分的数据,它会找到某一条能分开两类的直线,但具体是哪一条取决于初始化和样本顺序。SVM 问了一个更好的问题:在所有能分开数据的直线中,哪一条最好?
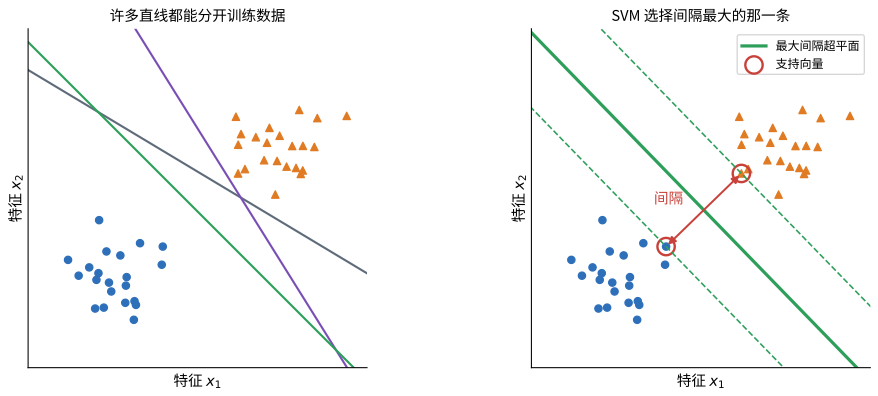
SVM 的答案是:选择离两类样本都尽可能远的那条线,即最大化间隔 (Margin)(图 5.1)。直觉上,间隔越大,分类器对新样本中的微小扰动就越不敏感,泛化能力越强。有趣的是,最终的决策边界只由离边界最近的少数样本决定,它们被称为支持向量 (Support Vector),这也是算法名字的由来。
核技巧
SVM 的另一件“法宝”是 核技巧 (Kernel Trick)。对于线性不可分的数据(比如 XOR),可以先把数据映射到更高维的空间,在那里它们可能变得线性可分。例如,把二维点 \(\left( x_{1},x_{2} \right)\) 映射到三维 \(\left( x_{1},x_{2},x_{1}x_{2} \right)\) 后,XOR 的四个点就可以被一个平面分开。核技巧的巧妙之处在于:SVM 的计算只涉及样本之间的内积,因此可以用一个核函数 \(k\left( \mathbf{x},\mathbf{x}' \right)\) 直接计算高维空间中的内积,而无需显式地进行映射——甚至可以映射到无穷维空间。
SVM 凸优化问题有唯一的全局最优解、有坚实的泛化理论、在中小规模数据集上表现出色,这让它在 2000 年代几乎成为“机器学习”的代名词。相比之下,神经网络需要调整大量超参数、容易陷入局部极小值、缺乏理论保证,因而被许多研究者视为“炼金术”。
决策树与集成学习
决策树
决策树 (Decision Tree) 是另一类极其流行的方法。它像一份“二十个问题”游戏:每个内部节点对一个特征提问,每个分支对应一个回答,每个叶子节点给出预测(图 5.2)。
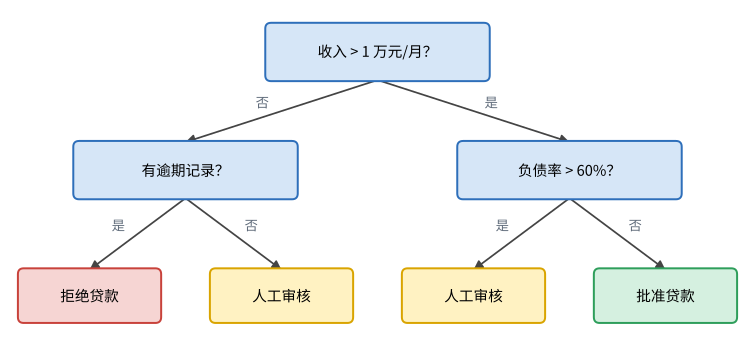
学习决策树的关键是在每个节点选择“最好”的问题。经典算法如昆兰 (Ross Quinlan) 的 ID3 和 C4.5,以及布雷曼 (Leo Breiman) 等人的 CART,用信息增益或基尼不纯度来衡量一个问题能把数据分得多“干净”。信息增益直接来自香农的信息熵——你会在卷三中看到,同样的熵概念也是训练大语言模型的交叉熵损失的基础。决策树的优点是直观、可解释、能处理混合类型的特征;缺点是单棵树容易过拟合。
集成学习:三个臭皮匠
集成学习 (Ensemble Learning) 的思想是把许多个“弱”模型组合成一个“强”模型。两个最重要的方法是:
-
Boosting:按顺序训练一系列模型,每个新模型重点关注前面模型分错的样本。弗罗因德 (Yoav Freund) 和沙皮尔 (Robert Schapire) 提出的 AdaBoost (Freund & Schapire, 1997) 是代表,后来发展出的梯度提升决策树 (Gradient Boosting Decision Tree, GBDT) 及其高效实现 XGBoost、LightGBM 至今仍是处理表格数据的首选。
-
Bagging 与随机森林:在数据的不同随机子集上独立训练许多棵树,然后投票。布雷曼 2001 年提出的 随机森林 (Random Forest) (Breiman, 2001) 在每次分裂时还会随机选择一部分特征,进一步增加多样性。
工程师笔记
即使在深度学习时代,对于结构化的表格数据(如金融风控、广告点击率预估中的用户特征),梯度提升树依然经常胜过神经网络。在 Kaggle 等数据科学竞赛中,它们长期是表格类题目的常胜将军。选择工具时,应当根据数据的类型和规模,而不是根据流行程度。
概率模型
统计学习时代的另一条主线是概率图模型 (Probabilistic Graphical Model)。朱迪亚·珀尔 (Judea Pearl) 在 1988 年出版的《智能系统中的概率推理》中系统阐述了贝叶斯网络 (Bayesian Network),用有向图表示随机变量之间的依赖关系,使得在不确定条件下进行推理变得可行 (Pearl, 1988)。珀尔因此获得了 2011 年图灵奖。
隐马尔可夫模型 (Hidden Markov Model, HMM) 是另一个明星:它假设观测序列(如语音信号)由一个不可见的状态序列(如音素)生成。从 20 世纪 80 年代到 2010 年前后,几乎所有主流语音识别系统都基于 HMM 与高斯混合模型的组合。朴素贝叶斯 (Naive Bayes) 分类器则在垃圾邮件过滤中大放异彩。
在语言领域,n 元语法模型 (n-gram Language Model) 统计词语序列出现的频率,用前 \(n - 1\) 个词预测下一个词的概率。这是“语言模型”概念的早期形态——今天的 GPT 依然在做同一件事:预测下一个词,只不过用的是深度神经网络,看的上下文长达数十万个词元。2003 年,约书亚·本吉奥 (Yoshua Bengio) 等人提出了神经概率语言模型 (Bengio et al., 2003),用神经网络和词向量替代计数统计,被视为神经语言模型的开山之作。
深蓝:搜索的巅峰
1997 年 5 月,IBM 的超级计算机 深蓝 (Deep Blue) 以 3.5:2.5 击败国际象棋世界冠军加里·卡斯帕罗夫 (Garry Kasparov),成为第一个在标准比赛条件下战胜在位世界冠军的计算机系统 (Campbell, Hoane & Hsu, 2002)。
深蓝的胜利常被视为 AI 的里程碑,但它在技术上更接近于符号时代的巅峰而非机器学习的胜利:它依靠数百块专用芯片,每秒能评估约两亿个局面,用 α-β 剪枝进行深度搜索;其评估函数包含数千个由国际象棋大师参与设计的特征。深蓝雄辩地证明了算力 + 搜索的威力——这是《苦涩的教训》中的另一个例证:最终胜出的不是模拟人类棋手思维的方法,而是能利用海量计算的方法。然而,同样的方法在围棋上完全行不通,因为围棋的分支因子(每步约 250 种走法,而国际象棋约 35 种)和局面评估的难度都高得多。攻克围棋要再等将近二十年(第 6 章)。
神经网络的蛰伏与坚守
在 SVM 的光芒下,神经网络进入了又一段“冷宫期”,但几项后来至关重要的工作恰恰诞生于此时。
梯度消失与 LSTM
研究者发现,用反向传播训练深层网络或处理长序列的循环神经网络 (Recurrent Neural Network, RNN) 时,误差信号在逐层(或逐时间步)反向传播时会呈指数衰减或爆炸,这就是 梯度消失 (Vanishing Gradient) 与 梯度爆炸 (Exploding Gradient) 问题 (Bengio, Simard & Frasconi, 1994)。它解释了为什么深层网络在当时难以训练。
1997 年,塞普·霍赫赖特 (Sepp Hochreiter) 和于尔根·施密德胡伯 (Jürgen Schmidhuber) 提出了 长短期记忆网络 (Long Short-Term Memory, LSTM) (Hochreiter & Schmidhuber, 1997)。LSTM 引入了一条“记忆传送带”和若干门控机制,让信息(和梯度)能够跨越很长的时间步而不衰减。LSTM 在 2010 年代中期成为语音识别和机器翻译的主力模型,直到被 Transformer 取代。门控和“给梯度修一条高速公路”的思想,在后来的残差网络和 Transformer 中以新的形式延续。
LeNet-5 与 MNIST
1998 年,LeCun 等人发表了长篇论文《基于梯度的学习在文档识别中的应用》(LeCun et al., 1998),系统地介绍了卷积网络 LeNet-5,并发布了手写数字数据集 MNIST。MNIST 包含 7 万张 \(28 \times 28\) 的手写数字灰度图,成为此后二十年机器学习领域的“果蝇”——几乎每一个新方法都会先在 MNIST 上测试。LeNet-5 只有大约 6 万个参数,但它的结构(卷积层—池化层—全连接层)已经具备了现代 CNN 的全部要素。
“加拿大黑手党”
在神经网络不受待见的年代,辛顿(多伦多大学)、本吉奥(蒙特利尔大学)和 LeCun(纽约大学)在加拿大高等研究院 (CIFAR) 的资助下,坚持开展神经网络研究,被戏称为“加拿大黑手党”。他们的坚守在 2006 年之后得到了丰厚的回报,三人共同获得了 2018 年度图灵奖(2019 年公布)。
Netflix 大奖与数据竞赛
2006 年,在线影片租赁公司 Netflix 设立了 100 万美元的大奖,奖励能把其推荐系统的预测误差降低 10% 的团队。这场持续三年的竞赛吸引了全球数万支队伍,最终在 2009 年由多个团队合并而成的“BellKor’s Pragmatic Chaos”夺冠。竞赛中涌现的矩阵分解 (Matrix Factorization) 技术成为推荐系统的标准方法,而冠军方案是数百个模型的集成——这再次印证了集成学习的威力。更重要的是,Netflix 大奖开创了“公开数据集 + 明确指标 + 排行榜”的研究范式,它直接影响了几年后 ImageNet 竞赛的设计。
| 方法 | 核心思想 | 至今仍在使用的场景 |
|---|---|---|
| SVM | 最大间隔 + 核技巧 | 小样本分类、作为基线方法 |
| 决策树 / 随机森林 | 递归划分特征空间;多树投票 | 可解释模型、特征重要性分析 |
| 梯度提升树 | 按顺序拟合残差的集成 | 表格数据、风控、点击率预估 |
| 朴素贝叶斯 | 基于条件独立假设的概率分类 | 文本分类基线 |
| HMM | 隐状态序列生成观测序列 | 生物序列分析、教学 |
| n-gram 语言模型 | 统计词序列频率预测下一个词 | 数据清洗与质量过滤 |
本章小结
-
统计学习时代的核心转变是从人工编写规则转向从数据中学习;米切尔用 \((T,P,E)\) 给出了机器学习的经典定义。
-
SVM 通过最大化间隔获得良好的泛化能力,并通过核技巧处理非线性问题,在 2000 年代占据主导地位。
-
决策树直观可解释;集成方法(随机森林、Boosting)把弱模型组合成强模型,至今仍是表格数据的利器。
-
贝叶斯网络、HMM、n-gram 语言模型等概率方法在语音和语言领域广泛应用;“预测下一个词”的语言模型思想由此延续到 GPT。
-
深蓝(1997)展示了算力与搜索的威力;LSTM(1997)与 LeNet-5(1998)等神经网络工作在“冷宫期”为深度学习的爆发奠定了基础。
习题
-
(概念) 用米切尔的 \((T,P,E)\) 框架描述下列学习问题:(a) 下围棋的程序;(b) 预测房价的模型;(c) 大语言模型的预训练。
-
(计算) 验证:把 XOR 的四个点映射为 \(\left( x_{1},x_{2},x_{1}x_{2} \right)\) 后,平面 \(x_{1} + x_{2} - 2x_{1}x_{2} = 0.5\) 可以把它们分开。分别计算四个点代入左边后的值。
-
(概念) 为什么 SVM 的决策边界只由支持向量决定?如果删除一个非支持向量的训练样本,决策边界会改变吗?
-
(概念) Bagging 与 Boosting 的主要区别是什么?哪一种更容易并行训练?
-
(思考) “简单模型 + 海量数据胜过复杂模型 + 少量数据”这一观点,在大模型时代是被证实了还是被修正了?
延伸阅读
-
Mitchell, T. M. (1997). Machine Learning. McGraw-Hill. 第 1 章。
-
Cortes, C., & Vapnik, V. (1995). Support-Vector Networks. Machine Learning, 20(3), 273–297.
-
Breiman, L. (2001). Random Forests. Machine Learning, 45(1), 5–32.
-
Hochreiter, S., & Schmidhuber, J. (1997). Long Short-Term Memory. Neural Computation, 9(8), 1735–1780.
-
周志华 (2016).《机器学习》. 清华大学出版社. ——优秀的中文机器学习教材,可作为卷四的参考书。