神经网络与深度学习概念速览
本章是通往卷五(深度学习)和卷六(Transformer)的桥梁。我们将用尽量少的数学,把神经网络最核心的几个概念串起来:神经元与激活函数、多层网络如何解决 XOR、反向传播的数值计算、表示学习,以及用 PyTorch 训练第一个神经网络。读完本章,你应当能看懂大多数深度学习代码的“骨架”。
从感知机到多层网络
现代神经元
现代神经网络中的“神经元”与感知机几乎相同:先计算输入的加权和,再通过一个非线性的激活函数 (Activation Function) \(\varphi\):
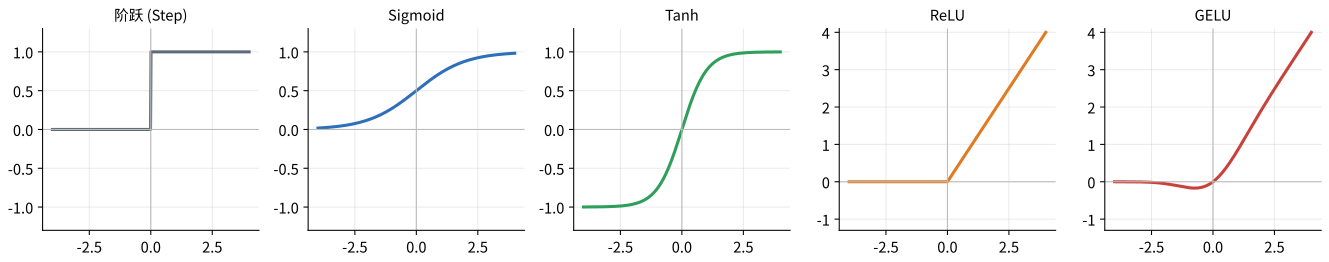
唯一的关键区别在于:激活函数必须是(几乎处处)可导的,这样才能用梯度下降训练。图 9.1 展示了几种常见的激活函数。
-
Sigmoid \(\sigma(z) = 1/\left( 1 + e^{- z} \right)\):把输入压缩到 \((0,1)\),早期神经网络的标准选择。缺点是在 \(|z|\) 较大时梯度趋于零(饱和),导致梯度消失。
-
Tanh:输出范围为 \(( - 1,1)\),以零为中心,同样存在饱和问题。
-
ReLU \(\max(0,z)\):计算极其简单,正半轴梯度恒为 1,不会饱和,是 AlexNet 成功的关键之一。
-
GELU \(z \cdot \Phi(z)\)(\(\Phi\) 为标准正态分布的累积分布函数):ReLU 的平滑版本,被 BERT、GPT 等模型采用。今天的许多大模型(如 Llama 系列)使用另一种称为 SwiGLU 的门控激活结构,卷六将详细介绍。
为什么必须是非线性的?
如果激活函数是线性的(例如 \(\varphi(z) = z\)),那么无论叠加多少层,整个网络仍然等价于一个线性函数:\(\mathbf{W}_{2}\left( \mathbf{W}_{1}\mathbf{x} \right) = \left( \mathbf{W}_{2}\mathbf{W}_{1} \right)\mathbf{x}\)。非线性激活函数是神经网络表达能力的来源。
多层感知机
把许多神经元排成一层,再把多层堆叠起来,就得到 多层感知机 (Multilayer Perceptron, MLP),也称全连接前馈网络(参见 图 4.3)。用矩阵形式写,一个两层的 MLP 为:
其中 \(\mathbf{h}\) 是隐藏层的输出。每个 Transformer 层中的前馈网络 (FFN) 正是这样一个两层 MLP,它在大模型中占据了约三分之二的参数。
例题 用两层网络解决 XOR
第 3 章证明了单层感知机无法实现 XOR。现在用一个有两个隐藏神经元的网络(激活函数为阶跃函数)来实现它:
-
隐藏神经元 \(h_{1} = \text{ step}\left( x_{1} + x_{2} - 0.5 \right)\),实现 OR;
-
隐藏神经元 \(h_{2} = \text{ step}\left( x_{1} + x_{2} - 1.5 \right)\),实现 AND;
-
输出 \(\hat{y} = \text{ step}\left( h_{1} - h_{2} - 0.5 \right)\),即“OR 且非 AND”。
::: {align="center"} | \(\left( x_{1},x_{2} \right)\) | \(h_{1}\) (OR) | \(h_{2}\) (AND) | \(h_{1} - h_{2} - 0.5\) | \(\hat{y}\) | |:--:|:--:|:--:|:--:|:--:| | (0, 0) | 0 | 0 | −0.5 | 0 | | (0, 1) | 1 | 0 | 0.5 | 1 | | (1, 0) | 1 | 0 | 0.5 | 1 | | (1, 1) | 1 | 1 | −0.5 | 0 | :::
关键的洞见在于:隐藏层把原始输入变换到了一个新的表示空间 \(\left( h_{1},h_{2} \right)\)。在原空间中线性不可分的 XOR,在新空间中变得线性可分了——四个点被映射为 \((0,0)\)、\((1,0)\)、\((1,0)\)、\((1,1)\),一条直线 \(h_{1} - h_{2} = 0.5\) 就能把它们分开。这正是“表示学习”的精髓。
反向传播:一个数值例子
第 4 章介绍了反向传播的思想,这里用一个最小的例子把它算一遍。考虑一个只有一个权重和一个偏置的“网络”:\(\hat{y} = wx + b\),损失为 \(L = \left( \hat{y} - y \right)^{2}\)。取 \(x = 2\),\(w = 3\),\(b = - 4\),目标 \(y = 3\)。
我们把计算过程画成一张 计算图 (Computational Graph)(图 9.2),图中每个节点是一个基本运算。
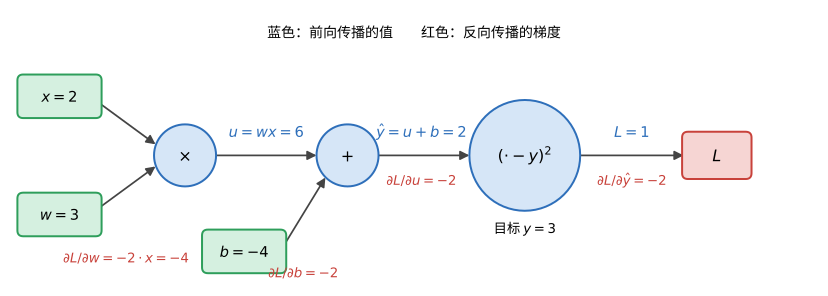
前向传播:\(u = wx = 6\),\(\hat{y} = u + b = 2\),\(L = (2 - 3)^{2} = 1\)。
反向传播:从输出开始,按链式法则逐个节点向回计算梯度:
-
\(\frac{\partial L}{\partial\hat{y}} = 2\left( \hat{y} - y \right) = 2 \times (2 - 3) = - 2\);
-
加法节点把梯度原样传给两个输入:\(\frac{\partial L}{\partial u} = \frac{\partial L}{\partial\hat{y}} \cdot 1 = - 2\),\(\frac{\partial L}{\partial b} = - 2\);
-
乘法节点把梯度乘以“另一个输入”:\(\frac{\partial L}{\partial w} = \frac{\partial L}{\partial u} \cdot x = - 2 \times 2 = - 4\),\(\frac{\partial L}{\partial x} = \frac{\partial L}{\partial u} \cdot w = - 6\)。
更新参数(学习率 \(\eta = 0.1\)):\(w \leftarrow 3 - 0.1 \times ( - 4) = 3.4\),\(b \leftarrow - 4 - 0.1 \times ( - 2) = - 3.8\)。验证:新的预测 \(\hat{y} = 3.4 \times 2 - 3.8 = 3.0\),恰好等于目标值,损失降为 0(在这个特例中一步就到达了最优)。
这个例子虽小,却包含了反向传播的全部要素:每个节点只需要知道自己的局部导数,再乘以从上游传来的梯度。对于有数千亿参数的网络,过程完全一样,只是节点更多、运算是矩阵形式。由于每个中间结果只需计算一次,反向传播计算所有梯度的代价与一次前向传播处于同一量级,这正是它高效的原因。
我们可以用 PyTorch 的自动微分 (Automatic Differentiation) 验证上面的结果:
import torch

x = torch.tensor(2.0)
w = torch.tensor(3.0, requires_grad=True)
b = torch.tensor(-4.0, requires_grad=True)
y = torch.tensor(3.0)

loss = (w * x + b - y) ** 2     # 前向传播:PyTorch 自动记录计算图
loss.backward()                 # 反向传播:自动计算所有梯度
print(loss.item(), w.grad.item(), b.grad.item())   # 1.0 -4.0 -2.0
表示学习与“深度”的意义
层次化的特征
为什么网络要“深”?传统机器学习中,工程师需要手工设计特征(如图像的边缘直方图),这称为特征工程 (Feature Engineering)。深度学习的核心卖点是 表示学习 (Representation Learning):网络自动从原始数据中学习有用的特征,而且是层次化的。
研究者对训练好的卷积网络进行可视化时发现:第一层学到的是边缘和颜色斑块;中间层学到的是纹理和简单形状(如圆形、条纹);更深的层学到的是物体的部件(如眼睛、车轮);最后几层则对应完整的物体类别。每一层都在前一层的基础上构建更抽象的概念。语言模型中也有类似现象:浅层更多地处理词法和句法,深层更多地处理语义和推理。
深度的效率
万能近似定理告诉我们,单隐藏层网络就能逼近任意连续函数,但它可能需要指数级数量的神经元。深层网络可以通过组合与复用中间特征,以少得多的参数表示同样复杂的函数——就像写程序时,通过函数调用复用代码,比把所有逻辑写在一个巨大的 if-else 里要高效得多。
三种经典架构
不同的数据类型适合不同的网络结构(回顾 图 7.1):
-
卷积神经网络 (CNN):使用在输入上滑动的小卷积核,具有局部连接和权重共享两大特点,适合图像等具有空间结构的数据。
-
循环神经网络 (RNN):按顺序处理序列,用隐状态传递历史信息,适合文本和语音。LSTM 和 GRU 是其改进版本。
-
Transformer:用自注意力让每个位置直接与所有位置交互,并行度高、易于扩展,已成为语言、视觉、语音乃至多模态领域的通用架构。
卷五将详细讲解 CNN 和 RNN,卷六将从零实现 Transformer。
文字如何进入神经网络
神经网络只能处理数字。大语言模型处理文本的流程如下:
-
分词 (Tokenization):把文本切分成词元序列。现代大模型通常使用字节对编码 (Byte Pair Encoding, BPE) 等子词算法,词表大小一般在 3 万到 25 万之间。例如“人工智能”可能被切成一个或几个词元,英文单词“unbelievable”可能被切成“un”“believ”“able”。
-
编号:每个词元映射为词表中的一个整数 ID。
-
嵌入 (Embedding):通过一个可学习的查找表(嵌入矩阵)把每个 ID 映射为一个 \(d\) 维向量(回顾 图 6.2)。
-
Transformer 层:经过数十层的注意力和前馈网络,每个位置的向量融合了上下文信息。
-
输出:最后一层的向量通过线性层和 Softmax 转换为词表上的概率分布,预测下一个词元。
分词器的设计看似是一个小细节,却会深刻影响模型的效率和能力,例如中文文本的压缩率和模型的算术能力。卷八将带你从零实现一个 BPE 分词器。
第一个 PyTorch 神经网络
最后,让我们用 PyTorch 训练一个真正的神经网络来学习 XOR——这一次,权重不再由我们手工设定,而是通过梯度下降自动学到:
import torch
import torch.nn as nn

torch.manual_seed(0)
X = torch.tensor([[0., 0.], [0., 1.], [1., 0.], [1., 1.]])
y = torch.tensor([[0.], [1.], [1.], [0.]])

model = nn.Sequential(          # 2 → 8 → 1 的多层感知机
    nn.Linear(2, 8), nn.Tanh(),
    nn.Linear(8, 1),
)
loss_fn = nn.BCEWithLogitsLoss()                    # 二分类交叉熵
opt = torch.optim.Adam(model.parameters(), lr=0.05)

for step in range(500):
    logits = model(X)                 # 1. 前向传播
    loss = loss_fn(logits, y)         # 2. 计算损失
    opt.zero_grad()                   # 3. 清空旧梯度
    loss.backward()                   # 4. 反向传播
    opt.step()                        # 5. 更新参数
    if step % 100 == 0:
        print(f"step {step:3d}  loss {loss.item():.4f}")

print(torch.sigmoid(model(X)).round().squeeze())    # 期望输出: [0, 1, 1, 0]
训练循环的五个步骤
请仔细记住这段代码中的五个步骤:前向传播 → 计算损失 → 清空梯度 → 反向传播 → 更新参数。无论是这个只有几十个参数的 XOR 网络,还是在上万块 GPU 上训练的千亿参数大模型,训练循环的核心结构都是这五步。区别在于:大模型的数据需要高效地流式加载,模型和优化器状态需要切分到多块 GPU 上,计算需要使用混合精度,还需要处理梯度裁剪、学习率调度、检查点保存和故障恢复——这些正是本系列卷七和卷八要解决的工程问题。
本章小结
-
现代神经元 = 加权和 + 可导的非线性激活函数;非线性是网络表达能力的来源。常用激活函数包括 Sigmoid、Tanh、ReLU、GELU 和 SwiGLU。
-
两层网络可以解决 XOR:隐藏层把输入变换到新的表示空间,使问题变得线性可分。
-
反向传播在计算图上按链式法则逐节点计算梯度:每个节点只需局部导数乘以上游梯度。PyTorch 的
loss.backward()自动完成这一过程。 -
深度网络学习层次化的表示,并能以更少的参数表示复杂函数。
-
大语言模型的输入流程:分词 → 编号 → 嵌入 → Transformer 层 → 输出概率分布。
-
训练循环的五个步骤:前向、损失、清空梯度、反向、更新。
习题
-
(计算) 计算 Sigmoid 函数的导数 \(\sigma'(z)\),并证明 \(\sigma'(z) = \sigma(z)(1 - \sigma(z))\)。\(\sigma'(z)\) 的最大值是多少?这对深层网络的梯度传播意味着什么?
-
(计算) 在本章反向传播例子中,若改为 \(x = 1\),\(w = 2\),\(b = 0\),\(y = 5\),计算前向传播的损失,以及 \(\partial L/\partial w\) 和 \(\partial L/\partial b\)。
-
(计算) 一个 MLP 的结构为 784 → 256 → 128 → 10(每层都有偏置)。它一共有多少个参数?
-
(编程) 运行本章的 PyTorch XOR 代码。把隐藏层激活函数从
Tanh换成恒等函数(删除nn.Tanh()),模型还能学会 XOR 吗?为什么? -
(编程) 修改 XOR 代码,把隐藏层神经元数从 8 改为 2,多次更换随机种子运行。是否每次都能成功?这说明了什么?
-
(概念) 用自己的话解释“表示学习”,并说明它与传统的“特征工程”有何不同。
延伸阅读
-
Goodfellow, I., Bengio, Y., & Courville, A. (2016). Deep Learning. MIT Press. 第 6 章(深度前馈网络)。
-
Cybenko, G. (1989). Approximation by Superpositions of a Sigmoidal Function. Mathematics of Control, Signals and Systems, 2(4), 303–314.
-
PyTorch 官方教程 “Learn the Basics”:https: