从零到大模型 · AI 工程师成长系列
从 AI 简史到训练世界一流的 Transformer 大语言模型 —— 一套为软件工程师定制的中文教材。
本系列面向已经具备扎实编程能力、希望成为专业 AI 工程师的读者,目标是让你最终能够独立参与乃至主导一个世界一流水准的 Transformer 大语言模型的训练:从数据、分词器、模型结构、GPU 内核与分布式训练,一路做到后训练对齐、推理部署与评测。
全系列共 11 卷,分为四个阶段。每一卷都包含:清晰的学习目标、先修要求、章节内容、动手项目和估计学时。所有内容均以简体中文编写,术语首次出现时附英文原文;所有插图均为原创绘制;只引用真实存在的经典论文与著作。
整个系列的总学习时间估计约 1400 小时。按每周 15–20 小时计算,大约需要 18–24 个月。各卷之间有明确的依赖关系(见路线图),但数学基础较好的读者可以快速浏览卷二、卷三,把它们当作参考手册。
学习路线图
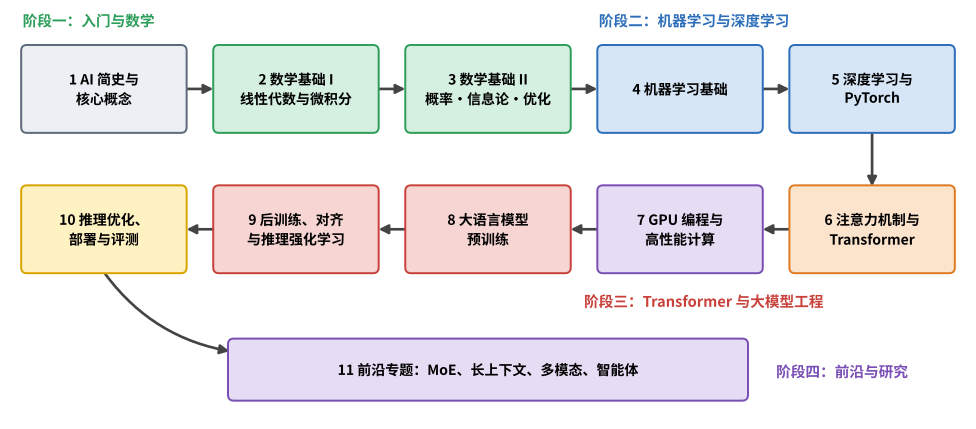
全部卷册
| 卷 | 书名 | 学时 | 状态 |
|---|---|---|---|
| 1 | 人工智能简史与核心概念 | 40 | ✅ 已完成 |
| 2 | 数学基础 I:线性代数与微积分 | 100 | 🕓 即将推出 |
| 3 | 数学基础 II:概率统计、信息论与优化 | 100 | 🕓 即将推出 |
| 4 | 机器学习基础 | 120 | 🕓 即将推出 |
| 5 | 深度学习与 PyTorch | 160 | 🕓 即将推出 |
| 6 | 注意力机制与 Transformer | 140 | 🕓 即将推出 |
| 7 | GPU 编程与高性能计算 | 150 | 🕓 即将推出 |
| 8 | 大语言模型预训练 | 200 | 🕓 即将推出 |
| 9 | 后训练、对齐与推理强化学习 | 160 | 🕓 即将推出 |
| 10 | 推理优化、部署与评测 | 120 | 🕓 即将推出 |
| 11 | 前沿专题:MoE、长上下文、多模态与智能体 | 100 | 🕓 即将推出 |
全系列合计约 1390 小时。
编写原则
- 从零实现:每个核心算法都先用 NumPy / PyTorch 从零写一遍,再使用成熟的库。
- 原理与工程并重:既推导公式,也测量显存、吞吐和 MFU;既懂“为什么”,也懂“怎么让它在一万块 GPU 上跑起来”。
- 小规模实验,大规模思考:绝大多数现象(规模定律、训练不稳定、过拟合)都可以在单卡小模型上观察到。
- 精读原始论文:每卷列出必读的经典论文,并在正文中逐段精读最关键的几篇。
- 中文语料与场景:项目尽量使用中文数据(古诗词、中文网页、中文数学题),并讨论中文分词与评测的特殊问题。
PDF 版本
本站内容以 Markdown 为单一来源,PDF 版本可以由同一份源文件生成,适合离线阅读与打印。