成为 AI 工程师:能力地图、算力与学习路线
前九章为你建立了 AI 的历史全景和概念框架。本章是全书的收尾,也是整个系列的起点。我们将讨论:一名能够训练世界级大模型的 AI 工程师需要具备哪些能力?训练大模型需要多少算力和内存,如何估算?AI 的安全与伦理问题为什么是工程师的责任?以及,接下来的十卷书将如何带你一步步到达目标。
大模型工程师的能力地图
训练一个世界级的大语言模型是一项庞大的系统工程,通常需要数十到数百人的团队协作。但无论在哪个岗位,优秀的大模型工程师都需要一个“T 形”的能力结构:在某一方向足够深入,同时对整个流程有足够的了解。
| 能力领域 | 核心内容 | 对应卷册 |
|---|---|---|
| 数学基础 | 线性代数、微积分(矩阵求导)、概率统计、信息论、优化理论 | 卷二、卷三 |
| 机器学习 | 经典算法、泛化、评估方法、实验设计 | 卷四 |
| 深度学习 | 反向传播、自动微分、CNN/RNN、训练技巧、PyTorch | 卷五 |
| 模型架构 | 注意力机制、Transformer 及其现代变体(RoPE、RMSNorm、SwiGLU、GQA 等) | 卷六 |
| 系统与算力 | GPU 架构、CUDA/Triton 编程、混合精度、通信原语 | 卷七 |
| 预训练 | 数据工程、分词器、规模定律、分布式训练(数据/张量/流水线并行、FSDP)、训练稳定性 | 卷八 |
| 后训练 | SFT、RLHF、DPO、面向推理的强化学习、安全对齐 | 卷九 |
| 推理与评测 | KV 缓存、量化、投机解码、服务系统、基准测试与评测方法 | 卷十 |
| 前沿 | 混合专家 (MoE)、长上下文、多模态、智能体 | 卷十一 |
关于数学
很多工程师对数学心存畏惧。好消息是,训练大模型所需的数学是有限且明确的:核心是线性代数(矩阵乘法、特征分解、范数)、多元微积分(梯度、链式法则、雅可比矩阵)、概率论(分布、期望、最大似然)和信息论(熵、交叉熵、KL 散度)。卷二和卷三将以“工程师友好”的方式讲授这些内容,每个概念都配有 NumPy 或 PyTorch 代码,让你“看得见”数学。
算力与内存:工程师的基本功
作为大模型工程师,你需要能够快速地进行“信封背面的估算”(Back-of-the-envelope Calculation)。这里介绍两个最基本的估算。
估算训练计算量
第 7 章介绍了训练计算量的近似公式 \(C \approx 6ND\)。与之对应,推理时每生成一个词元大约需要 \(2N\) 次浮点运算。GPU 的峰值算力用 FLOPS(每秒浮点运算次数)衡量,而实际训练中能达到的比例称为 模型 FLOPs 利用率 (Model FLOPs Utilization, MFU)。在大规模训练中,MFU 达到 40%–50% 通常就被认为是相当优秀的水平。
估算显存占用
训练时 GPU 显存主要被以下几部分占用:
-
模型参数:使用 BF16(16 位浮点数)存储时,每个参数占 2 字节;
-
梯度:与参数同样大小,每个参数 2 字节;
-
优化器状态:Adam 优化器为每个参数维护一阶矩和二阶矩两个状态,混合精度训练中通常还要保存一份 FP32 的参数主副本,三者合计每个参数 12 字节;
-
激活值 (Activations):前向传播的中间结果,用于反向传播,其大小与批大小、序列长度和模型结构有关。
例题 一个 70 亿参数模型需要多少显存?
设模型参数量 \(N = 7 \times 10^{9}\)。
仅推理(BF16):参数占 \(7 \times 10^{9} \times 2\text{ 字节 } = 14 \times 10^{9}\) 字节 \(\approx 14\) GB(这里按 \(1\text{ GB } = 10^{9}\) 字节计算)。再加上 KV 缓存等开销,一块 24 GB 显存的消费级显卡可以运行。若使用 4 比特量化,参数仅需约 3.5 GB。
完整训练(混合精度 + Adam):参数 2 + 梯度 2 + 优化器状态 12 = 每个参数 16 字节,合计 \(7 \times 10^{9} \times 16 = 112\) GB,这还不包括激活值。即使是 80 GB 显存的数据中心 GPU,单卡也装不下。
这就是为什么需要 ZeRO / FSDP 等技术把参数、梯度和优化器状态切分到多块 GPU 上,以及用激活重计算 (Activation Checkpointing) 来节省激活值内存。对于千亿参数级别的模型,还需要张量并行和流水线并行。这些技术将在卷七和卷八中详细讲解并动手实践。
硬件与软件栈
表 10.2 大模型开发的软硬件栈(列举的均为常见代表,并非完整清单)
| 层次 | 代表技术 |
|---|---|
| 硬件 | GPU(如 NVIDIA 数据中心 GPU)、AI 加速器(如 Google TPU)、高带宽内存 (HBM) |
| 互联 | 机内高速互联(如 NVLink)、机间网络(如 InfiniBand、RoCE) |
| 底层编程 | CUDA、Triton、通信库 NCCL |
| 深度学习框架 | PyTorch(主流)、JAX |
| 分布式训练 | PyTorch FSDP、DeepSpeed、Megatron-LM、TorchTitan 等 |
| 推理服务 | vLLM、SGLang、TensorRT-LLM、llama.cpp 等 |
| 生态与工具 | Hugging Face(模型与数据集仓库)、Weights & Biases(实验追踪) |
这些工具迭代极快,具体版本和接口可能在你阅读本书时已经变化。本系列的原则是:讲透原理,以主流工具为载体进行实践。只要理解了原理,切换到新工具只是查阅文档的问题。
AI 安全与伦理:工程师的责任
能力越大,责任越大。随着 AI 系统越来越强大并被广泛部署,其风险也日益受到重视 (Bommasani et al., 2021)。作为训练模型的工程师,你直接决定了模型学到什么、如何行为。以下是你需要始终放在心上的几类问题:
-
偏见与公平 (Bias and Fairness):模型会学到训练数据中的社会偏见,并可能在招聘、信贷等场景中放大不公平。
-
幻觉 (Hallucination):模型可能自信地生成看似合理但完全错误的内容,在医疗、法律等高风险领域尤其危险。
-
隐私与版权:训练数据可能包含个人隐私信息或受版权保护的内容,模型有可能“背诵”出训练数据。
-
滥用:强大的模型可能被用于生成虚假信息、网络攻击或其他有害用途。
-
对齐与可控性:随着模型能力的提升,如何确保它们的目标和行为始终符合人类意图,是 AI 领域最根本的长期挑战之一。
这些问题没有简单的答案,但工程师可以做很多实际的工作:认真进行数据清洗与过滤、构建全面的安全评测、在后训练阶段进行安全对齐、对模型的局限性保持诚实透明。卷九和卷十将专门讨论安全对齐与红队测试 (Red Teaming)。
本系列学习路线
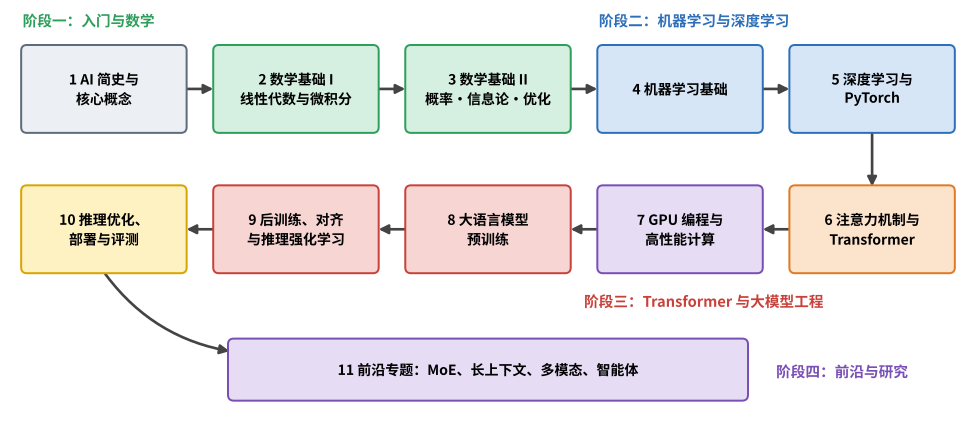
图 10.1 展示了本系列十一卷书的学习路线,分为四个阶段。
-
阶段一:入门与数学(卷一至卷三)。建立全景认知,打下数学基础。如果你的数学基础较好,可以快速浏览卷二、卷三,把它们当作参考手册。
-
阶段二:机器学习与深度学习(卷四、卷五)。掌握经典机器学习和深度学习的原理与 PyTorch 实践。完成本阶段后,你应当能够独立训练和调试中等规模的神经网络。
-
阶段三:Transformer 与大模型工程(卷六至卷十)。这是本系列的核心。你将从零实现 Transformer,学习 GPU 编程,完成一个小型语言模型的完整预训练、后训练、评测与部署。
-
阶段四:前沿与研究(卷十一)。了解混合专家、长上下文、多模态和智能体等前沿方向,学会阅读最新论文并跟踪领域进展。
整个系列的总学习时间估计为 1200 至 1600 小时。如果每周投入 15 至 20 小时,大约需要 18 个月到两年。这听起来很长,但请记住:你学到的不是某个工具的用法,而是一门正在重塑世界的技术的完整知识体系。
如何高效学习
最后,分享几条经过检验的学习建议:
-
动手第一:每一个算法都要亲手实现一遍。“我看懂了”和“我写出来了”之间,往往隔着无数个细节。本系列的每一卷都配有编程项目,请务必完成。
-
从零实现,再用工具:先用 NumPy 实现反向传播,再用 PyTorch;先从零写 Transformer,再用 Hugging Face。理解底层之后,工具才会真正为你所用。
-
读原始论文:本书引用的每一篇经典论文都值得一读。刚开始可能很吃力,但读论文是 AI 工程师最重要的长期技能。建议从 Transformer 论文开始,每周至少精读一篇。
-
小规模实验,大规模思考:你不需要上千块 GPU 来理解大模型。在单卡上训练一个几千万参数的模型,就能观察到规模定律、训练不稳定、过拟合等几乎所有重要现象。
-
记录与复现:养成写实验日志的习惯,记录每次实验的配置、结果和思考。尝试复现论文中的结果,这是检验理解程度的最好方法。
-
加入社区:关注开源项目,阅读优秀的代码库,参与讨论。AI 领域的进展极快,社区是最好的老师。
历史小故事 Karpathy 的建议
前特斯拉 AI 总监、OpenAI 创始成员安德烈·卡帕西 (Andrej Karpathy) 以其“从零开始”的教学风格闻名,例如用几百行代码实现一个完整的 GPT 训练程序。他经常强调,理解深度学习的最好方式是亲手从最基础的部分构建一切。本系列的卷五和卷六也将采用类似的“从零构建”思路。
本章小结
-
大模型工程师需要“T 形”能力结构:数学、机器学习、深度学习、模型架构、系统与算力、预训练、后训练、推理与评测。
-
两个基本估算:训练计算量 \(C \approx 6ND\);混合精度 Adam 训练每个参数约需 16 字节显存(不含激活值)。
-
大模型的软硬件栈从 GPU 和高速互联,到 CUDA/Triton、PyTorch、分布式训练框架和推理引擎。
-
AI 安全与伦理(偏见、幻觉、隐私、滥用、对齐)是工程师不可推卸的责任。
-
本系列分为四个阶段、十一卷;学习的关键在于动手实现、阅读论文、小规模实验和持续记录。
习题
-
(计算) 一个 130 亿参数的模型,用 BF16 进行推理需要多少 GB 显存存放参数?用混合精度 Adam 训练(不含激活值)需要多少 GB?
-
(计算) 用 \(C \approx 6ND\) 估算:在 15 万亿词元上训练一个 80 亿参数的模型需要多少 FLOPs?若使用 1024 块 GPU,每块峰值算力为 \(10^{15}\) FLOPS,MFU 为 40%,需要多少天?
-
(计算) 一个 700 亿参数的模型,每生成一个词元约需多少次浮点运算?如果生成 1000 个词元,总计需要多少 FLOPs?
-
(概念) 列举大语言模型可能带来的三类风险,并分别说明工程师可以在训练流程的哪个环节加以缓解。
-
(实践) 根据 图 10.1 和你自己的时间安排,制订一份为期三个月的学习计划,明确每周的学习目标和要完成的编程练习。
延伸阅读
-
Bommasani, R., et al. (2021). On the Opportunities and Risks of Foundation Models. arXiv:2108.07258.
-
Kaplan, J., et al. (2020). Scaling Laws for Neural Language Models. arXiv:2001.08361. ——重点阅读关于计算量估算的部分。
-
Rajbhandari, S., Rasley, J., Ruwase, O., & He, Y. (2020). ZeRO: Memory Optimizations Toward Training Trillion Parameter Models. SC20. ——显存估算的经典参考。