Transformer 与大模型时代:2017 年至今
2017 年 6 月,谷歌的八位研究者在 arXiv 上发布了一篇标题颇为大胆的论文:《注意力就是你所需要的一切》(Attention Is All You Need) (Vaswani et al., 2017)。论文提出的 Transformer 架构完全抛弃了循环和卷积,只依靠注意力机制处理序列。没有人预料到,这个最初为机器翻译设计的模型,会在五年后催生出 ChatGPT,并成为几乎所有前沿 AI 系统的基础。本章是全书历史部分的最后一章,也是整个系列的“预告片”:这里提到的每一项技术,都将在后续各卷中被详细拆解并亲手实现。
Transformer:注意力就是一切
为什么要抛弃 RNN
RNN 和 LSTM 按时间步逐个处理序列:要计算第 100 个词的隐状态,必须先算完前 99 个。这带来两个问题:
-
无法并行:训练时不能充分利用 GPU 的并行计算能力,难以扩展到大规模数据;
-
长距离依赖困难:第 1 个词的信息要经过 99 步传递才能到达第 100 个词,途中容易衰减。
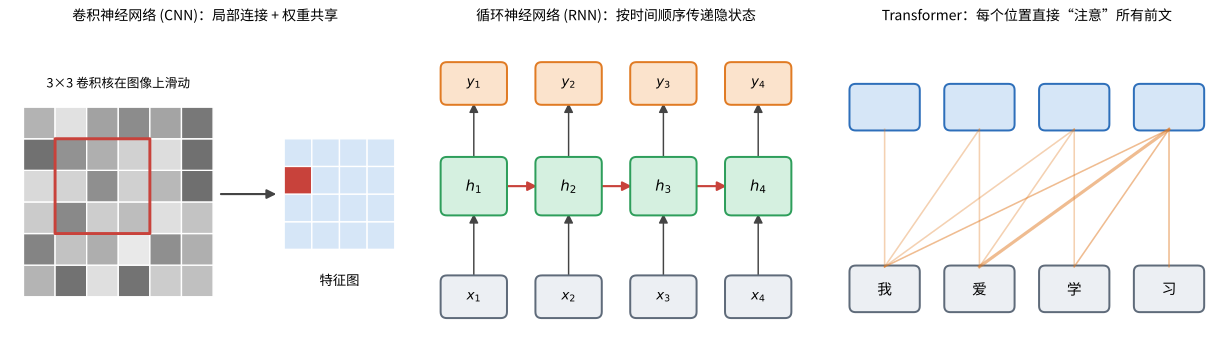
Transformer 的核心是 自注意力 (Self-Attention):序列中的每个位置都直接与所有其他位置交互,一步之内就能获取全局信息,而且所有位置的计算可以完全并行。图 7.1 对比了三种架构处理信息的方式。
自注意力的直觉
自注意力可以理解为一种“软”的字典查询。对于每个词元,模型计算三个向量:查询 (Query) \(\mathbf{q}\)、键 (Key) \(\mathbf{k}\) 和值 (Value) \(\mathbf{v}\)。要更新某个位置的表示时,用它的查询向量与所有位置的键向量计算相似度,经过 Softmax 归一化后作为权重,对所有位置的值向量加权求和。用矩阵形式写出来,就是 Transformer 论文中最著名的公式:
其中 \(d_{k}\) 是键向量的维度,除以 \(\sqrt{d_{k}}\) 是为了防止点积过大导致 Softmax 饱和。例如在句子“小猫没有喝牛奶,因为它不渴”中,计算“它”的表示时,模型会给“小猫”分配较高的注意力权重,从而理解“它”指代的是小猫。
Transformer 还使用了多头注意力 (Multi-Head Attention)——并行地运行多组注意力,每一组可以关注不同类型的关系(如语法关系、指代关系);以及位置编码 (Positional Encoding)——因为注意力本身对顺序不敏感,需要额外注入位置信息。每一层在注意力之后接一个前馈网络 (Feed-Forward Network),并配以残差连接和层归一化 (Layer Normalization)。
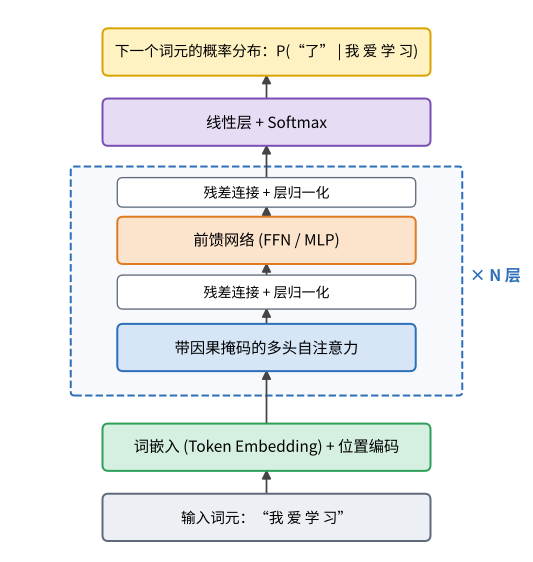
图 7.2 展示了今天大语言模型最常用的仅解码器 (Decoder-only) 结构。原始 Transformer 是用于翻译的编码器—解码器结构,但后来的 GPT 系列证明,只保留带因果掩码 (Causal Mask,即每个位置只能看到它之前的词元) 的解码器部分,就足以构建强大的语言模型。卷六将带你从零开始,逐行实现这样一个模型。
预训练范式的确立
GPT 与 BERT
2018 年,两项工作确立了“预训练 + 微调”(Pre-training + Fine-tuning) 的新范式:
-
GPT(OpenAI,2018):在大量无标签文本上用“预测下一个词”的目标训练一个 Transformer 解码器,然后在具体任务上用少量标注数据微调 (Radford et al., 2018)。
-
BERT(谷歌,2018 年发布,2019 年发表于 NAACL):使用 Transformer 编码器,通过“完形填空”式的掩码语言建模 (Masked Language Modeling) 进行预训练——随机遮住句子中 15% 的词,让模型根据上下文双向预测被遮住的词 (Devlin et al., 2019)。BERT 在发布时刷新了 11 项自然语言理解任务的最好成绩。
这两种方法都属于 自监督学习 (Self-Supervised Learning):训练标签来自数据本身(下一个词、被遮住的词),因此可以利用互联网上几乎无穷无尽的文本,而不需要昂贵的人工标注。这是大模型得以“大”的根本前提。
在随后几年里,BERT 系列(编码器)一度在理解类任务上占优,但 GPT 系列(解码器)凭借其生成能力和扩展性最终胜出。今天的主流大语言模型几乎都是仅解码器结构。
下一个词元预测
GPT 的训练目标值得仔细品味。给定一段文本,模型被要求在每个位置预测下一个词元 (Token)——词元是模型处理文本的基本单位,可能是一个字、一个词或一个词的片段。
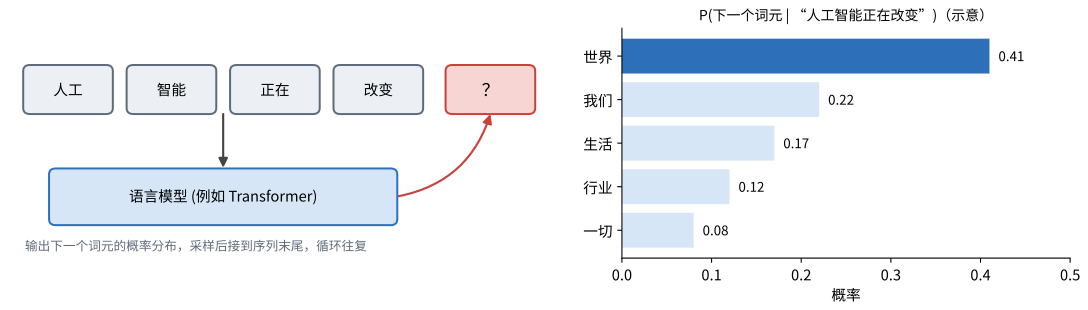
如 图 7.3 所示,模型输出的是一个覆盖整个词表的概率分布。训练时,我们希望模型给真实的下一个词元分配尽可能高的概率,这等价于最小化交叉熵损失 (Cross-Entropy Loss):
其中 \(\theta\) 表示模型的所有参数,\(T\) 是序列长度。生成文本时,模型反复执行“预测下一个词元 → 采样 → 追加到序列末尾”的循环,这称为自回归生成 (Autoregressive Generation)。
这个目标看起来简单得近乎平庸,但它蕴含着惊人的力量:为了准确预测下一个词,模型必须学会语法、事实知识、逻辑推理,甚至对说话者意图的推测。设想预测一部推理小说最后一页“凶手是……”之后的那个名字——这需要理解整部小说。一些研究者把这种观点概括为“压缩即智能”:能更好地预测(压缩)数据的模型,必然在某种程度上理解了产生数据的世界。
规模的力量
GPT-2 与 GPT-3
2019 年,OpenAI 发布了 15 亿参数的 GPT-2 (Radford et al., 2019),展示了语言模型在没有任何专门训练的情况下完成翻译、摘要、问答等任务的能力(零样本,Zero-shot)。2020 年,GPT-3 将参数量提升到 1750 亿 (Brown et al., 2020),并展示了 上下文学习 (In-context Learning) 能力:只需在提示中给出几个示例(少样本,Few-shot),模型就能“领会”任务并完成它,而无需更新任何参数。
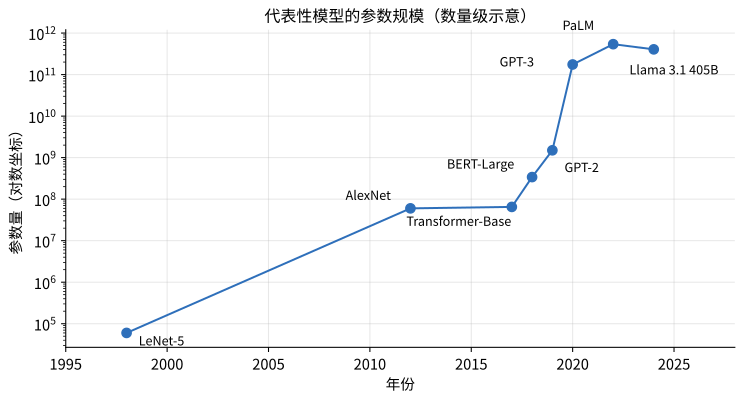
图 7.4 展示了模型参数规模的爆炸式增长。从 1998 年的 LeNet-5 到 2020 年的 GPT-3,参数量增长了约 300 万倍。
规模定律
为什么要把模型做得这么大?2020 年,OpenAI 的卡普兰 (Jared Kaplan) 等人发表了《神经语言模型的规模定律》(Kaplan et al., 2020),系统研究了语言模型的性能与三个因素之间的关系:模型参数量 \(N\)、训练数据量 \(D\)(词元数)和训练计算量 \(C\)。他们发现,在很大的范围内,测试损失与这些因素之间呈现出非常规律的幂律关系:
即模型每扩大一定倍数,损失就按固定比例下降,在对数坐标下是一条直线(图 7.5)。
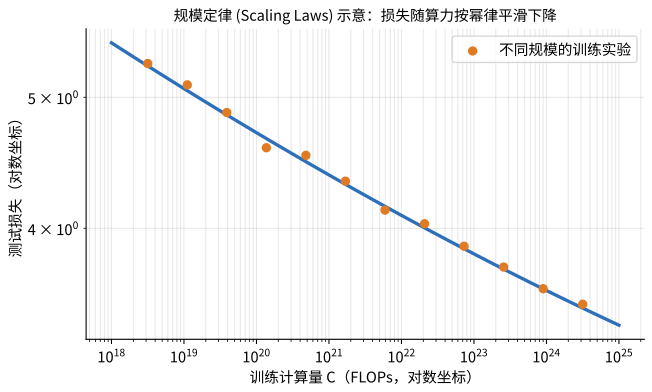
规模定律 (Scaling Laws) 的意义怎么强调都不为过:它让训练大模型从“炼金术”变成了可以预测的工程。研究者可以先用小模型做实验,拟合出规律,再外推预测大模型的表现,从而决定如何分配数以亿计美元的算力预算。
2022 年,DeepMind 的霍夫曼 (Jordan Hoffmann) 等人在 Chinchilla 论文中修正了卡普兰等人的结论 (Hoffmann et al., 2022):在固定计算预算下,模型参数量和训练词元数应该同比例增长,粗略的经验法则是每个参数大约对应 20 个训练词元。按照这个标准,GPT-3 等早期大模型都“训练不足”——参数太多而数据太少。700 亿参数的 Chinchilla 在 1.4 万亿词元上训练后,性能超过了参数量大得多的模型。这一发现深刻影响了此后大模型的设计。今天的模型为了降低推理成本,往往在远超“Chinchilla 最优”的数据量上训练较小的模型。卷八将详细讨论规模定律及其在训练决策中的应用。
例题 估算训练计算量
训练一个 Transformer 语言模型所需的浮点运算次数 (FLOPs) 有一个广泛使用的近似公式(Kaplan et al., 2020):
其中 \(N\) 是参数量,\(D\) 是训练词元数,系数 6 来自前向传播(每个参数每个词元约 2 次运算)与反向传播(约 4 次)之和。
以 GPT-3 为例:\(N = 1.75 \times 10^{11}\),\(D \approx 3 \times 10^{11}\)(3000 亿词元),则
这与 GPT-3 论文中报告的约 \(3.14 \times 10^{23}\) FLOPs 吻合。假设一块 GPU 的实际有效算力为每秒 \(10^{14}\) 次浮点运算(100 TFLOPS),则需要约 \(3.15 \times 10^{9}\) GPU·秒,约合 100 GPU·年。这就是为什么训练大模型需要成千上万块 GPU 并行工作——如何高效地做到这一点,是卷七和卷八的核心内容。
涌现能力
研究者还观察到,某些能力(如多步算术、思维链推理)似乎在模型规模达到一定程度后才“突然”出现,在小模型上几乎为零。这被称为 涌现能力 (Emergent Abilities) (Wei et al., 2022a)。不过,后续研究指出,部分“涌现”现象可能与评估指标的选择有关——使用连续的指标时,能力的提升往往是平滑的 (Schaeffer, Miranda & Koyejo, 2023)。这是一个仍在争论中的话题,也提醒我们:如何评测模型,会影响我们对模型的认识。卷十将专门讨论评测问题。
从语言模型到 AI 助手
对齐:InstructGPT 与 RLHF
预训练得到的语言模型擅长“续写”,但不一定擅长“听从指令”。你问它“如何学习机器学习?”,它可能接着写出更多类似的问题,而不是回答你。此外,它还可能输出有害、虚假或带有偏见的内容。让模型的行为符合人类意图和价值观的过程,称为 对齐 (Alignment)。
2022 年,OpenAI 的欧阳龙 (Long Ouyang) 等人发表了 InstructGPT 论文 (Ouyang et al., 2022),提出了一个三步流程:
-
监督微调 (Supervised Fine-Tuning, SFT):让标注员编写高质量的“指令—回答”示范数据,在其上微调预训练模型;
-
训练奖励模型 (Reward Model):让模型对同一指令生成多个回答,由标注员排序,训练一个能预测人类偏好的奖励模型;
-
强化学习:以奖励模型为“裁判”,用强化学习算法 PPO 进一步优化语言模型。
后两步合称 基于人类反馈的强化学习 (Reinforcement Learning from Human Feedback, RLHF)。令人瞩目的是,经过 RLHF 的 13 亿参数 InstructGPT,在人类评估中比 1750 亿参数的原始 GPT-3 更受青睐。
ChatGPT 时刻
2022 年 11 月 30 日,OpenAI 发布了基于类似方法训练的对话产品 ChatGPT。它在发布后约两个月内用户数就突破了一亿,被普遍认为是当时增长最快的消费级应用之一。ChatGPT 让普通大众第一次直观地感受到了大语言模型的能力,引发了全球范围内的 AI 热潮。2023 年 3 月,OpenAI 发布了 GPT-4 (OpenAI, 2023),它能够接受图像输入,并在许多专业考试中达到较高水平。
开源模型与百花齐放
ChatGPT 之后,大模型领域进入了激烈竞争的阶段。2023 年 2 月,Meta 发布了 LLaMA 系列模型 (Touvron et al., 2023),证明了在公开数据上训练的中等规模模型也能取得很强的性能,并带动了开源大模型生态的繁荣。此后,Llama 2、Llama 3、Mistral、Qwen(通义千问)、DeepSeek 等开源或开放权重模型相继发布,中国团队在其中扮演了越来越重要的角色。开放权重模型让个人开发者和研究者也能研究、微调和部署大模型——这也是你通过本系列学习后将要大展身手的舞台。
与此同时,对齐技术也在简化。2023 年,拉法伊洛夫 (Rafael Rafailov) 等人提出了 直接偏好优化 (Direct Preference Optimization, DPO) (Rafailov et al., 2023),证明可以不训练单独的奖励模型、不使用强化学习,直接从人类偏好数据中优化语言模型,大大降低了对齐的工程难度。
推理模型:让模型“多想一会儿”
思维链
2022 年,魏 (Jason Wei) 等人发现,只要在提示中给出几个“一步一步推理”的示例,大模型解决数学应用题等多步推理问题的能力就会大幅提升。这种方法称为 思维链提示 (Chain-of-Thought Prompting) (Wei et al., 2022b)。直觉上,让模型把中间步骤写出来,相当于给了它更多的“计算时间”和“草稿纸”。
用强化学习训练推理
2024 年 9 月,OpenAI 发布了 o1 模型,它在回答之前会生成很长的内部思维链,在数学竞赛和编程竞赛题上的表现大幅超越此前的模型 (OpenAI, 2024)。这揭示了一个新的扩展维度:除了扩大训练计算量,还可以扩大推理时计算量 (Test-time Compute)——让模型“想得更久”。
2025 年 1 月,中国公司深度求索发布了 DeepSeek-R1 (DeepSeek-AI, 2025),并公开了技术细节和模型权重。其研究表明,通过大规模强化学习——奖励信号仅来自答案是否正确等可自动验证的规则——模型可以自发地学会反思、验证和尝试不同解法等复杂的推理行为。DeepSeek-R1 以相对较低的训练成本达到了与顶尖闭源模型相当的推理水平,引起了全球关注。用强化学习提升推理能力,迅速成为大模型后训练的核心方向,这正是卷九的重点内容。
回望 AlphaGo
推理模型的思路与 AlphaGo 有着深刻的相似之处:先通过模仿人类数据(预训练 / 学习棋谱)获得基础能力,再通过强化学习(可验证的奖励 / 棋局胜负)超越模仿,并在推理时投入更多计算(长思维链 / 树搜索)。AI 历史的各条线索,在这里交汇了。
走向科学与更广阔的世界
大模型时代的 AI 不只是聊天机器人。2020 年,DeepMind 的 AlphaFold 2 在蛋白质结构预测竞赛 CASP14 中取得了接近实验精度的结果,解决了困扰生物学界半个世纪的难题 (Jumper et al., 2021)。2024 年,诺贝尔化学奖的一半授予了 AlphaFold 的主要开发者德米斯·哈萨比斯 (Demis Hassabis) 和约翰·江珀 (John Jumper)(另一半授予了蛋白质设计领域的大卫·贝克 (David Baker));同年的诺贝尔物理学奖授予了霍普菲尔德和辛顿。AI 研究在同一年获得两项诺贝尔奖,这在科学史上是前所未有的。
与此同时,多模态模型能够同时理解和生成文本、图像、音频和视频;智能体 (Agent) 系统能够使用工具、浏览网页、编写和运行代码,完成多步骤的复杂任务。这些前沿方向将在卷十一中介绍。
苦涩的教训
2019 年,强化学习先驱理查德·萨顿发表了一篇只有两页的短文《苦涩的教训》(Sutton, 2019)。他回顾了 AI 七十年的历史,得出一个结论:
“从 70 年的 AI 研究中可以得出的最大教训是:利用计算的通用方法最终是最有效的,而且优势巨大。”
萨顿指出,在国际象棋、围棋、语音识别和计算机视觉中,研究者一次又一次地试图把人类知识植入系统,这在短期内总是有效的,也让研究者获得成就感;但从长期来看,它总会遇到瓶颈,最终被基于搜索和学习、能随算力增长而扩展的方法超越。这个教训之所以“苦涩”,是因为它否定了研究者对自己精巧设计的偏爱。
回顾本书第 2 至 7 章的历史,你会发现这条教训贯穿始终:专家系统输给了统计学习,人工设计的特征输给了深度学习,精心设计的语言学规则输给了在海量文本上训练的 Transformer。作为一名立志训练世界级大模型的工程师,你需要同时掌握两件事:能够随规模扩展的通用方法(Transformer、梯度下降、规模定律),以及让这些方法真正在数万块 GPU 上高效运行的工程能力。这正是本系列后续各卷的使命。
本章小结
-
Transformer(2017)用自注意力取代循环和卷积,实现了完全并行的训练和直接的长距离依赖建模;仅解码器结构是今天大语言模型的主流。
-
GPT 与 BERT(2018)确立了“自监督预训练 + 微调”的范式;“下一个词元预测”的简单目标蕴含了强大的学习信号。
-
规模定律揭示了损失随参数量、数据量和计算量呈幂律下降;Chinchilla 指出参数量与数据量应同比例扩展。训练计算量可用 \(C \approx 6ND\) 估算。
-
InstructGPT 的 SFT + RLHF 流程把语言模型变成了有用的助手;ChatGPT(2022 年 11 月)引爆了全球 AI 热潮;DPO 简化了对齐流程。
-
思维链和基于强化学习的推理模型(o1、DeepSeek-R1)开辟了“推理时计算”这一新的扩展维度。
-
萨顿的《苦涩的教训》:能随算力扩展的通用方法最终会胜出。
习题
-
(概念) 列举 RNN 相比 Transformer 的两个主要缺点,并说明 Transformer 是如何克服的。
-
(计算) 在式 (7.1) 中,设序列长度为 \(n\),键向量维度为 \(d_{k}\)。矩阵 \(\mathbf{Q}\mathbf{K}^{\top}\) 的形状是什么?当 \(n\) 从 1000 增加到 100000 时,存储该矩阵所需的内存增加多少倍?这对长上下文模型意味着什么?
-
(计算) 按照 Chinchilla 的“每个参数约 20 个词元”经验法则,一个 70 亿参数的模型应该在多少词元上训练?用 \(C \approx 6ND\) 估算其训练计算量。
-
(计算) 假设你有 1000 块 GPU,每块的有效算力为 \(4 \times 10^{14}\) FLOPS,训练一个计算量为 \(10^{24}\) FLOPs 的模型需要多少天?
-
(概念) 简述 RLHF 的三个步骤。DPO 省去了其中的哪些部分?
-
(思考) “下一个词元预测”仅仅是在学习统计规律,还是能产生真正的理解?结合第 1 章的中文屋论证,谈谈你的看法。
延伸阅读
-
Vaswani, A., et al. (2017). Attention Is All You Need. NeurIPS. ——本系列最重要的一篇论文,卷六将逐段精读。
-
Brown, T., et al. (2020). Language Models are Few-Shot Learners. NeurIPS.
-
Kaplan, J., et al. (2020). Scaling Laws for Neural Language Models. arXiv:2001.08361.
-
Hoffmann, J., et al. (2022). Training Compute-Optimal Large Language Models. arXiv:2203.15556.
-
Ouyang, L., et al. (2022). Training Language Models to Follow Instructions with Human Feedback. NeurIPS.
-
DeepSeek-AI (2025). DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning. arXiv:2501.12948.
-
Sutton, R. (2019). The Bitter Lesson. 个人网站短文。